
走出静态文本的象牙塔:LLM 智能体评估的深度范式转移
A Survey on Evaluation of LLM-based Agents
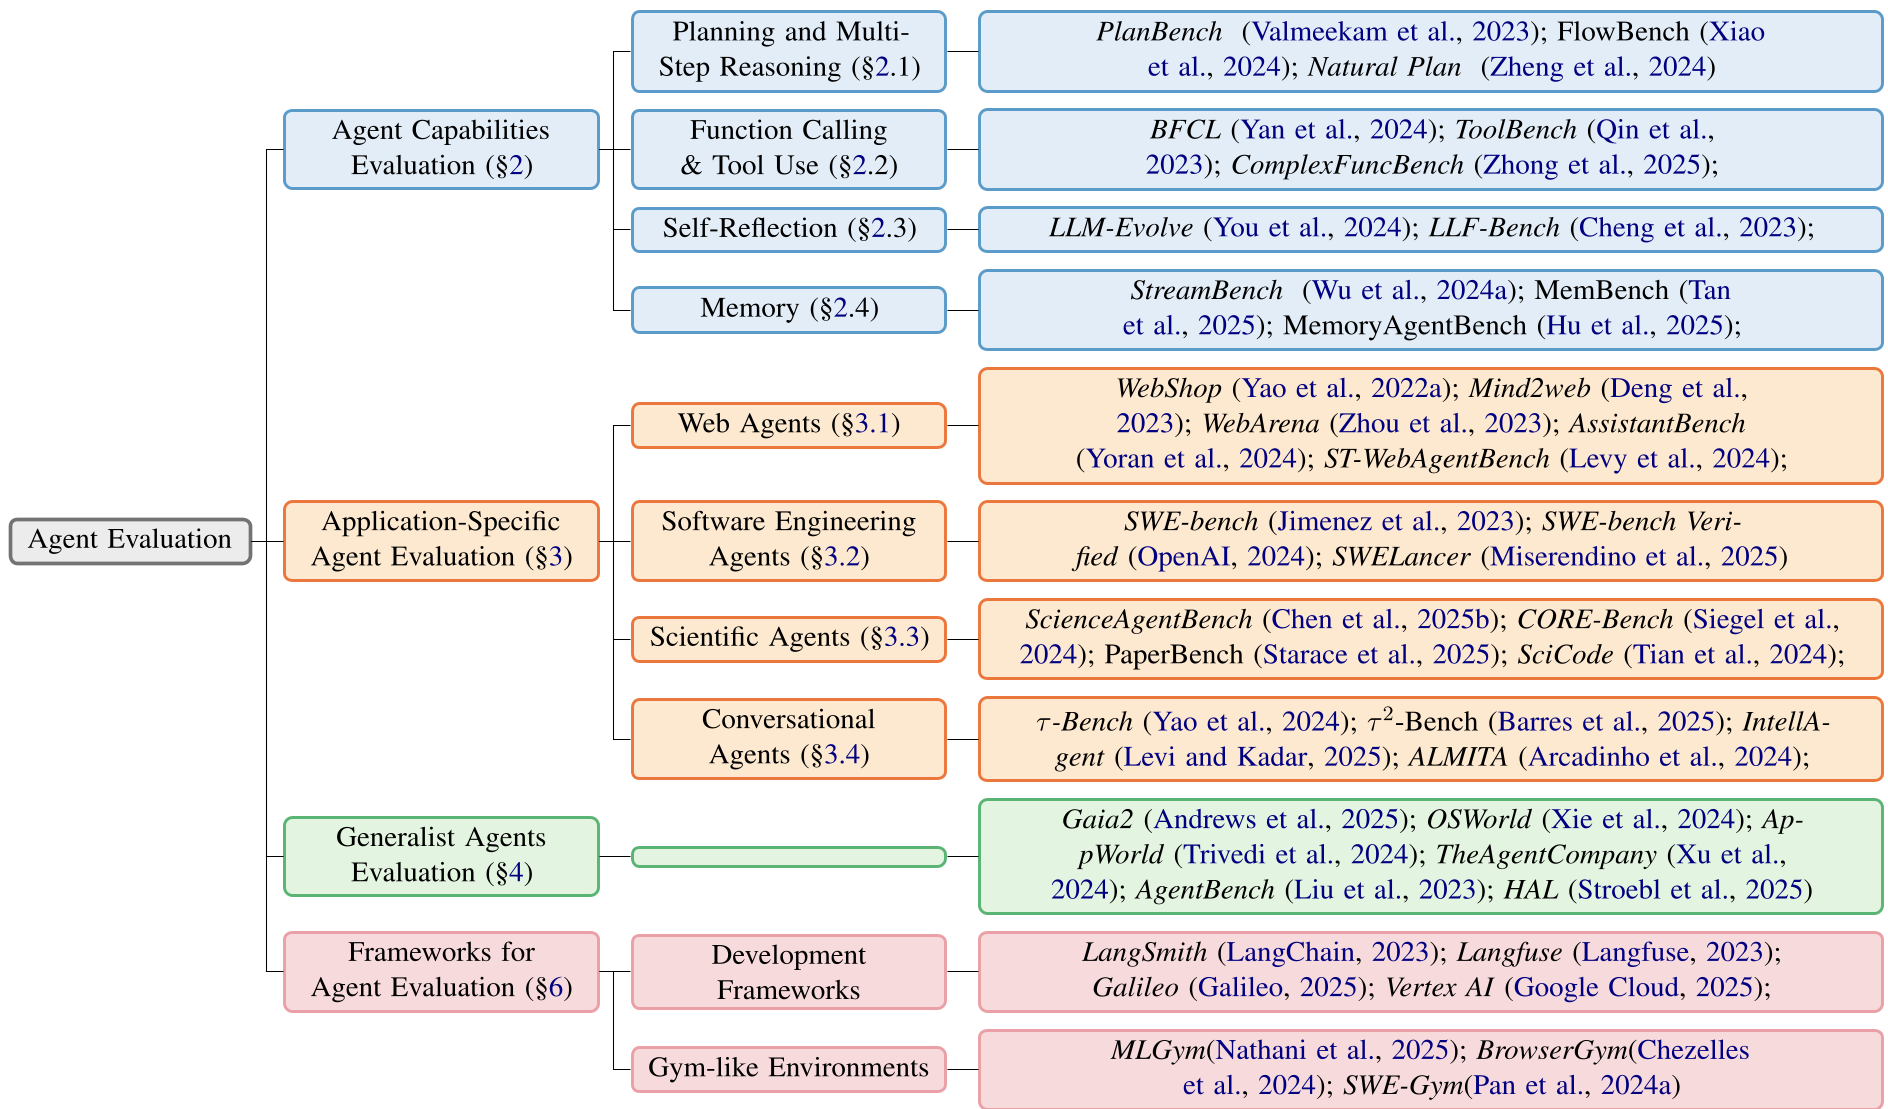
本文是学术界首份关于基于 LLM 的智能体(LLM-based Agents)评估方法的全面综述。文章系统梳理了从基础能力(规划、工具使用、反思、记忆)到特定领域应用(Web、软件工程、科学研发、对话系统)的评估基准,并分析了评估框架的发展趋势。
TL;DR
随着大模型从“会聊天的百科全书”演变为“能干活的数字员工”,我们对它的评价标准正经历一场剧变。本文综述了 LLM 智能体评估的现状,指出评估已从简单的文本匹配转向复杂的环境交互,并重点分析了规划、工具调用、记忆和特定领域(如物理、Web、软件工程)的最新评估基准。
背景定位:为何传统评估在 Agent 时代失效?
传统 LLM 评估(如 MMLU)是静态的:给一个 Prompt,得一个 Answer。但 Agent 是动态的。它需要规划路径、调用外部工具、处理环境反馈并自我修正。如果评估环境不具备动态性(Dynamic Environments),我们根本无法观察到 Agent 在面对错误时的“层叠效应”(Cascading Effects)——即一步错步步错的真实逻辑溃败。
核心能力:Agent 的四个支柱
论文将智能体的核心素质拆解为以下四个关键能力:
- 规划与多步推理 (Planning):将复杂目标分解为可执行子任务。目前 SOTA 模型在超过 10 步的长程任务中表现依然不佳。
- 工具调用 (Tool Use):从简单的单步 API 搜索演进到了如
ComplexFuncBench等需要隐式参数推理和长上下文处理的复杂场景。 - 自我反思 (Self-Reflection):模型能否根据环境报错(如 Python 代码运行失败)自动修复逻辑?目前这一块仍缺乏标准化的成熟基准。
- 记忆 (Memory):分为情景记忆(过去发生了什么)和语义记忆(事实知识)。挑战在于如何在超长对话中保持一致性(Long-range Consistency)。
垂直领域:从 Web 到软件工程
智能体在不同职业场景下的表现评估存在巨大差异:
- Web Agents:评估已从简易模拟器转向
WebArena这种真实的沙盒环境,要求模型能够处理 HTML DOM 树或直接进行视觉导航(WebVoyager)。 - SWE Agents (软件工程):
SWE-bench改变了游戏规则。它不再考算法题,而是直接给一个真实的 GitHub Issue,要求 Agent 在数千个文件的 Repo 中定位 Bug 并提交可运行的补丁。 - Scientific Agents:关注智能体在科学发现、实验设计甚至是论文同行评审(Peer Review)中的表现。
核心维度对比:我们如何衡量一个好基准?
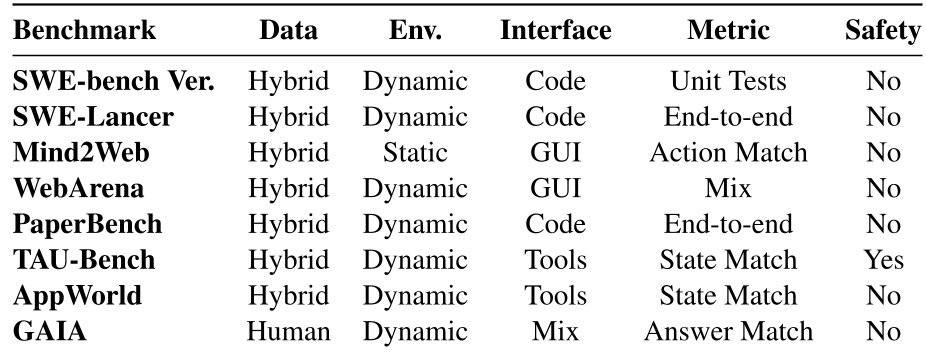
作者提出了一个多维分析框架,对比了当前主流的 Benchmark(如上文表格 1 所示):
| 维度 | 现状与趋势 |
|---|---|
| 数据来源 | 趋向“人类+机器”混合模式,由人类确保任务的真实价值,机器负责规模化生成。 |
| 环境类型 | 从静态(Static)不可交互转向动态(Dynamic)实时反馈。 |
| 交互接口 | 从纯文本转向代码/终端(Terminal)及图形用户界面(GUI)。 |
| 安全性 | 这是一个重大的评估缺失项。目前的基准很少测试 Agent 是否会恶意删除数据库或违反隐私政策。 |
行业洞察:评估框架的现状
对于开发者而言,LangSmith、Weights & Biases 和 Google Vertex AI 提供了从“端到端响应”到“中间步骤(Stepwise)”的监控。目前的先进技术是 Trajectory-Based Assessment(轨迹评估),通过对比 Agent 的执行路径与人类专家路径的对齐程度,定位 Agent 到底是死在了“规划”阶段还是“执行”阶段。
深度思考:未来的五个坑
- 粒度化评估:不能只看任务成没成功(二进制指标),要看它绕了多少弯路。
- 成本指标:有些 Agent 效果好是靠烧 Token 堆出来的,未来的评估必须包含“单位成本下的任务完成度”。
- 自动化评估 (Agent-as-a-Judge):用更高级的 Agent 来评审低级 Agent 的执行日志,解决人类评估太慢的问题。
- 安全护栏:在 Agent 真正进入企业生产环境前,我们必须有一套“红队测试”来防范它的破坏性行为。
- 解耦评估:到底是因为底层的 GPT-4o 变强了,还是你的 ReAct 框架写得好?未来的研究需要独立评估模型与脚手架(Harness)。
总结
智能体评估正在从一门“技术手段”变成一门“严谨科学”。随着基准测试日益动态化和逼真化,我们离真正的“全自动人工智能”又近了一步。