
SoK:Gen-AI 时代的 AIGC 水印——从“内容挂件”到“内生安全”的范式转移
SoK: On the Role and Future of AIGC Watermarking in the Era of Gen-AI
2024-11-19
总结
问题
方法
结果
要点
摘要
本文提出了 AIGC 水印(AIGC Watermarking)的首个正式定义,并将其建模为贯穿 AIGC 供应链(从数据集到生成的最终内容)的动态流。文章系统化地梳理了不同模态(文本、图像、音频、视频、跨模态)的水印技术,并提出了涵盖内生性、跨模态属性等高级特性的分类法。
TL;DR
随着生成式 AI(GenAI)的爆发,虚假信息与版权侵权风险激增。浙江大学与南洋理工大学的研究团队在本文中,首次为 AIGC 水印 建立了数学化的供应链模型,将其从传统的内容后期处理(Post-processing)提升到了模型生成逻辑的**内生(Endogeneity)**高度,并系统性地梳理了跨模态背景下的安全攻防图谱。
1. 痛点:为什么传统水印在 AIGC 时代吃不开了?
在传统数字水印时代,我们通过修改图像的最小有效位(LSB)或变换域(DCT)来打标签。但在 AIGC 时代,这种方案面临三大死穴:
- 模态割裂:以前是图打图标,现在是“文生图”、“图生视频”,水印如何在不同模态转译中不丢失?
- 内容重构:生成模型本质上是在做重采样。攻击者只需通过一遍
Encoding -> Noise -> Decoding(再生攻击),就能洗掉绝大多数外部嵌入水印,且不损画质。 - 黑盒不可溯:如何证明一段文字是 GPT-4 生成的,而不是某个特定用户通过 Prompt 诱导生成的?
2. 核心机制:AIGC 水印的供应链定义
作者别出心裁地将 AIGC 过程建模为一个根树(Rooted Tree)。
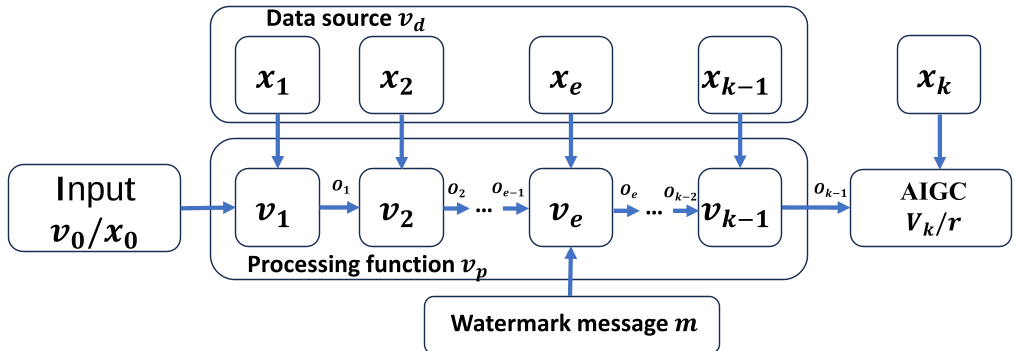
在这个模型中:
- 节点 (Nodes):代表数据源(Prompt)或处理函数(Diffusion Step)。
- 边 (Edges):代表跨模态的数据流。
- 水印注入 (Embedding):不再仅仅是作用于根节点(最终 AIGC 内容),而是通过修改中间处理函数 为 ,使生成的每一个像素或 Token 从诞生起就带有“基因编码”。
这种**内生性(Endogeneity)**使得水印与内容质量产生了深度绑定——想挖掉水印,就必然破坏模型生成的语义一致性。
3. 不同模态的 SOTA 方案巡礼
- 文本 (Text):从简单的格式修改进化到了 Logits 偏置。在 LLM 采样阶段,通过修改 Token 概率分布,使生成序列符合特定的伪随机特征。
- 图像 (Image):代表作如 Tree-ring Watermarks,通过在 Diffusion 模型的潜空间(Latent Space)注入特定频率分布,实现肉眼不可见但反演极其鲁棒的特征。
- 音频与视频 (Audio/Video):面临时间连续性挑战。目前趋向于使用 跨模态特征对齐(如 V2A-Mark),利用视觉和音频的关联性互为水印,大幅提升了防篡改定位能力。
4. 攻防博弈:魔高一丈的 Security 挑战
论文详细拆解了三类核心攻击:
- Forgery(伪造):通过对抗训练,让一个普通图像被识别器误认为带有某大厂的水印。
- Removal(擦除):重点关注 再生攻击(Regeneration Attack)。利用 VAE 强行将图像降噪重构,这是目前内生水印最大的天敌。
- Detection(检测):攻击者利用检测器接口,不断微调扰动直到绕过水印检测。
5. 资深主编点评 (Editorial Insight)
这篇 SoK (Systematization of Knowledge) 的价值在于它跳出了“怎么打水印”的技术细节,站在了全生命周期治理的高度。
核心启示:
- 从“外挂”转向“插座”:未来的 AIGC 水印必须具备 即插即用(Plug-and-Play) 属性,不需要重训练整个 Llama 就能快速部署个性化水印。
- 语义级水印是终局:既然像素级特征容易被洗掉,那么在文本语义、图像关键逻辑上做不可逆偏置,可能是对抗再生攻击的唯一有效手段。
- 合规即标准:文章末尾提到的各国监管政策(如中国 CAC 的标识规定、EU 的 AI Act)正倒逼技术落地。水印将从“选配技术”变成模型交付的“标配准入”。
总结
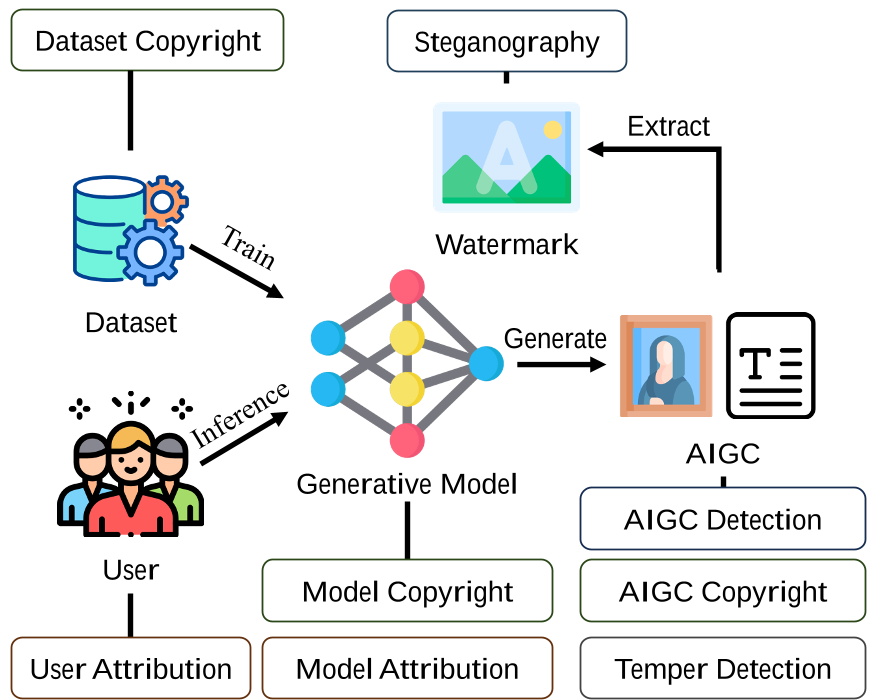
水印技术正处于从“数字版权标识”向“生成内容可信任性底座”转变的关键期。对于 AI 开发者而言,理解水印如何渗透进 Dataset -> Model -> Output 的每一个环节,不仅是技术追求,更是未来应对安全监管的必修课。