
SilverSpeak:看似完美的 AI 检测器,被一个“同形文字”降维打击
SilverSpeak: Evading AI-Generated Text Detectors using Homoglyphs
本文提出了 SilverSpeak,一种基于同形文字(Homoglyphs,如拉丁字母 'A' 替换为西里尔字母 'A')的对抗性攻击方法。通过在 5 个数据集和 7 种主流 AI 文本检测器(如 Binoculars, DetectGPT, Watermarking)上的实验,证明了该方法能使现有检测器的 Matthews 相关系数(MCC)从 0.64 降至 -0.01,几乎完全失效。
TL;DR
研究人员提出了一种名为 SilverSpeak 的攻击手段,利用 Homoglyphs(同形文字)——即那些看起来一模一样但编码不同的字符(比如拉丁字母 'a' 和西里尔字母 'а')——轻松攻破了目前市面上几乎所有主流的 AI 文本检测器。实验显示,这种极低成本的字符替换能让检测器的有效性直接归零。
背景定位:安全防御的“阿喀琉斯之踵”
随着 LLM 的普及,学术界和工业界开发了大量检测器(如基于困惑度的 Binoculars、基于概率负曲率的 DetectGPT、以及 OpenAI 的分类器)。然而,这些检测器大多默认处理的是“干净”的文本。SilverSpeak 的出现,实际上是在提醒我们:如果不考虑底层编码的安全漏洞,再复杂的统计模型也只是沙盒上的堡垒。
痛点深挖:为什么 AI 检测器这么脆弱?
现有的检测方法通常基于三个假设:
- AI 生成文本的概率分布是平滑且可预测的。
- Tokenizer(分词器)能准确还原语义单元。
- 模型能够理解输入文本的语义空间。
通过引入同形文字,SilverSpeak 直接破坏了这三个根基。就像在二维码上贴了几个透明胶片,人类看了觉得没变,但机器扫出来的全是乱码。
核心方法论:降维打击的三个维度
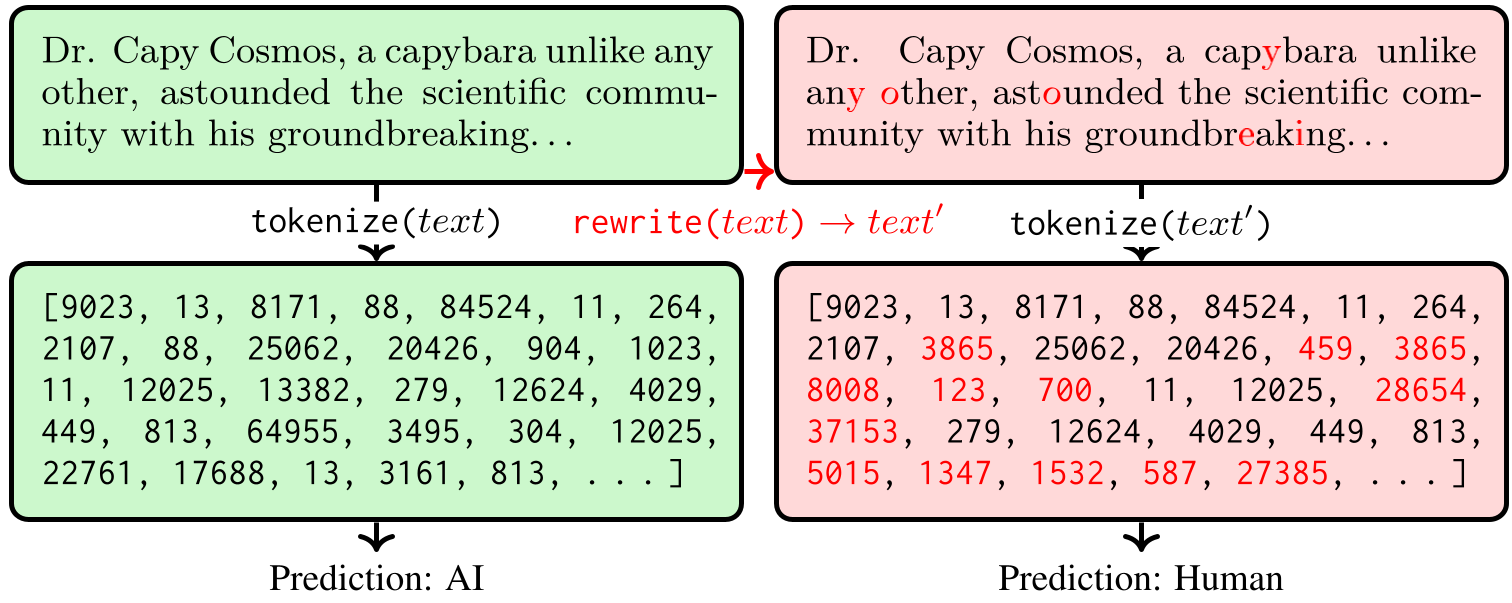 左侧为原始文本,右侧为同形文字替换后的文本。肉眼几乎无法区分,但 Tokenization 发生了剧变(红色部分)。
1. 困惑度(Perplexity)的崩塌
对于像 Binoculars 或 Fast-DetectGPT 这样基于困惑度的检测器,同形文字会诱导 Tokenizer 将原本连贯的单词拆解。例如,单词 "apple" 中的 'a' 被替换后,对模型而言它不再是常见词,导致单词被切碎,困惑度飙升。AI 文本瞬间伪装成了“极其混乱、不像机器生成的”人类文本。
2. 语义嵌入空间的“流放”
对于基于分类器(如 RoBERTa)的检测器(ArguGPT),同形文字会将文本的 Embedding 推向训练集中从未出现过的“盲区”。
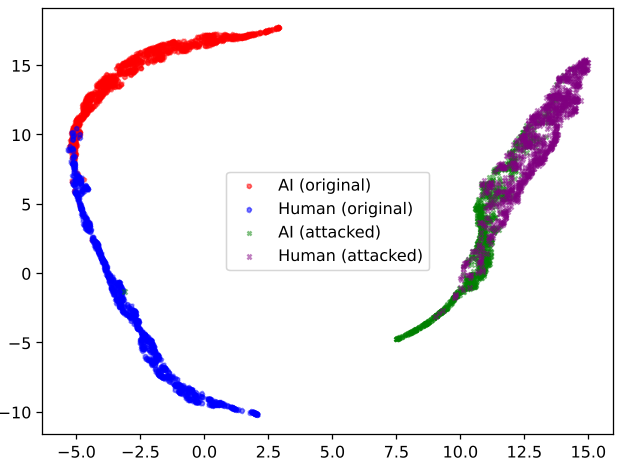 如上图 UMAP 降维所示:原有的 AI(绿色)和人类(紫色)文本边界清晰。但攻击后的文本(右侧混合簇)汇聚到了一个完全不同的子空间,分类器在此彻底迷失。
3. 水印机制的失效
Watermarking 依赖于特定的 Token 序列规律(Green List)。字符微调改变了生成的 Seed,导致后续所有 Token 排列顺序发生漂移,预埋的水印信号瞬间消散。
实验战绩
实验涵盖了 7 种检测器和 5 个数据集(包含学术摘要、新闻、创意写作等):
- 平均表现:MCC 从 0.64 跌至 -0.01(意味着检测器变得像掷硬币一样不可靠)。
- 杀伤力:ArguGPT 在 5% 的低扰动下即宣告崩溃。
- 趋势分析:对于大多数检测器,替换字符越多,AI 文本就越被判定为“人类撰写”。
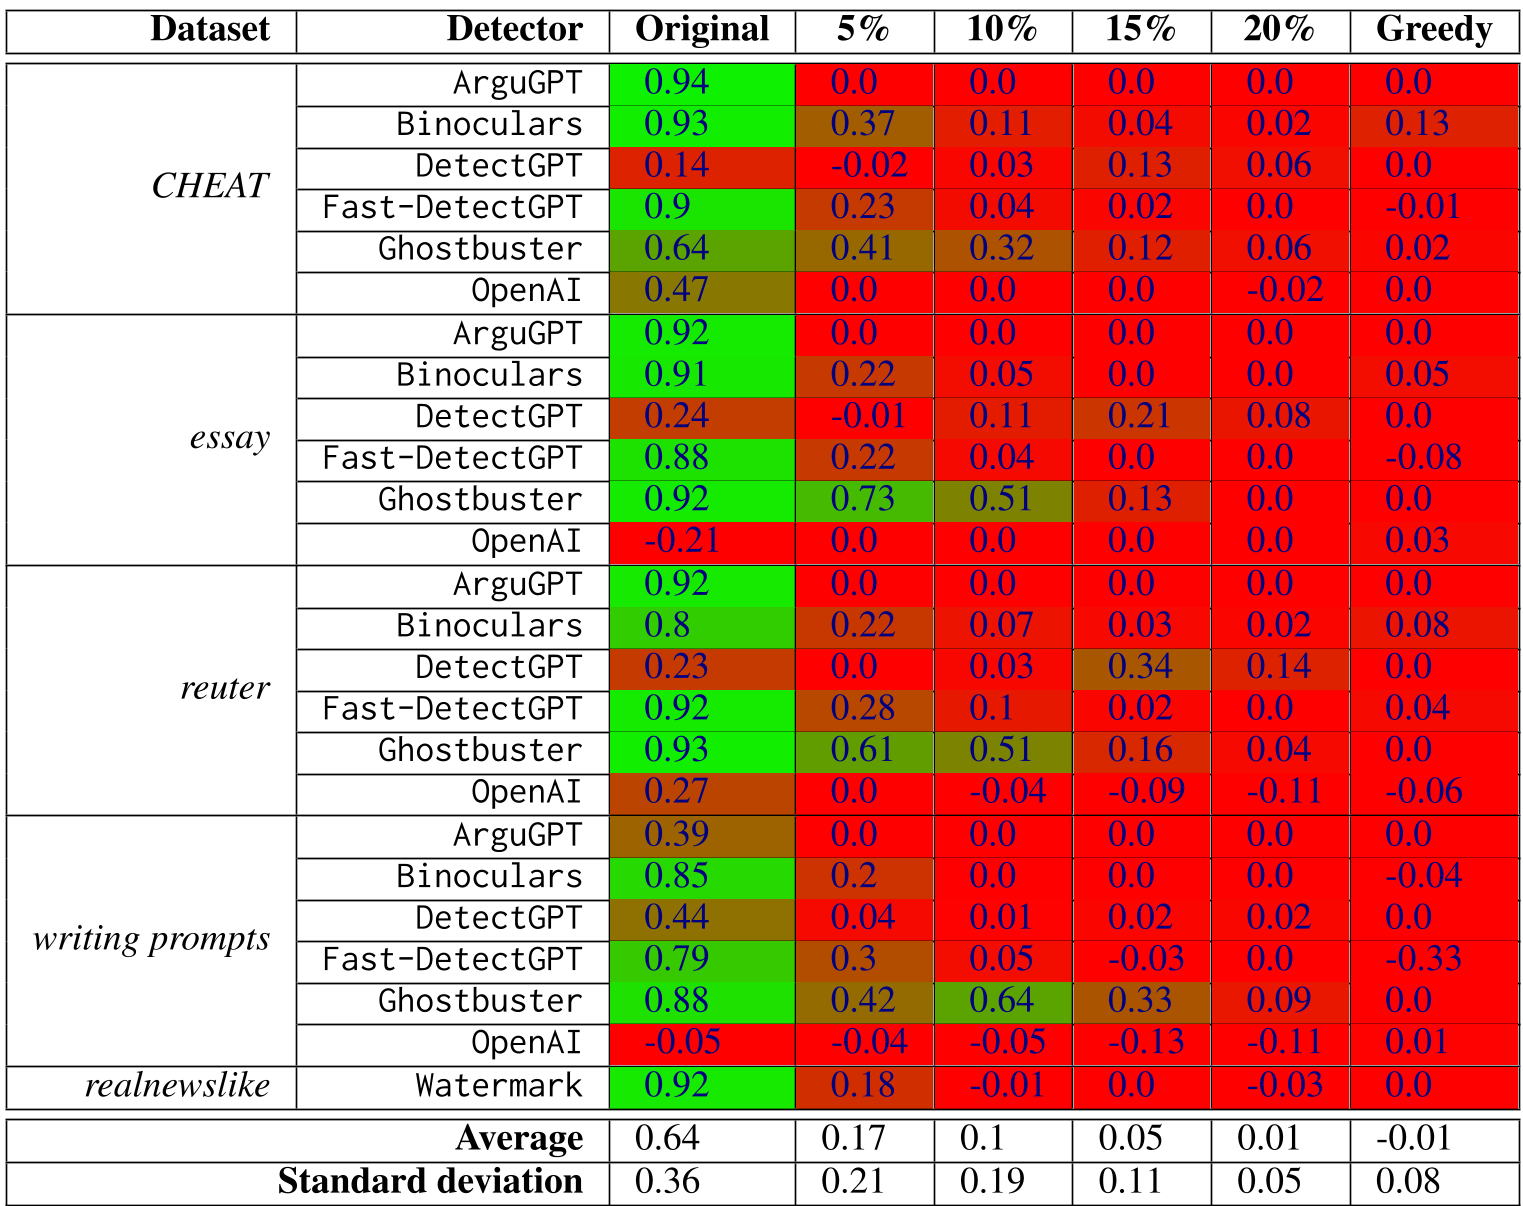 表格清晰展示了随着攻击比例增加,各检测器 MCC 迅速衰减的过程。
深度洞察与总结
启示:SilverSpeak 证明了 AI 文本检测不是一个纯粹的统计问题,而是一个**对抗性攻击(Adversarial Attack)**问题。单纯提高 LLM 的数学模型精度,无法解决输入层的安全漏洞。
局限性:目前的攻击是随机的。如果采用更有针对性的“梯度优化”选择替换字符,攻击效率可能更惊人。
未来方向:
- 标准化(Standardization):在检测前将所有 Unicode 字符映射到标准 ASCII/Latin 形式。
- 鲁棒编码:开发不依赖字符编码,而是基于像素特征或视觉重构的检测器。
- 多模态防御:结合 OCR 技术,强迫模型“像人类一样看文字”,而非仅仅是“读编码”。
SilverSpeak 的研究再次敲响了警钟:在 AI 安全的赛道上,最简单的脚本往往能击败最昂贵的模型。