
SAF-GAN:突破卷积局限,基于自监督注意力与特征融合的 T2I 新架构
基于自监督注意和图像特征融合的文本生成图像方法
本文提出了 SAF-GAN,一种基于自监督注意力和图像特征融合的增强型文本生成图像(T2I)模型。该方法通过引入 CotNet 自监督模块提升初始特征质量,并利用注意力特征融合(AFF)机制确保多阶段生成过程中的语义一致性,在 CUB 和 COCO 数据集上均达到了 SOTA 性能。
TL;DR
在文本生成图像(Text-to-Image)领域,层级式 GAN 虽然是经典路线,但其“先天不足”——初始阶段的卷积运算易忽略全局语义,导致后续生成的图像往往出现逻辑错误。本文提出的 SAF-GAN 通过在初始阶段嵌入 CotNet(自监督注意力) 模块,并利用 AFF(注意力特征融合) 增强多尺度特征流,成功解决了细节缺失与结构性畸变问题。
1. 痛点:为什么之前的模型容易画出“两头鸟”?
传统的 T2I 模型(如 AttnGAN)主要依赖以下流程:提取文本特征 -> 低分辨率初绘 -> 多阶段上采样精细化。 然而,这种模式存在两大顽疾:
- 卷积的局限性:卷积核视野受限,在生成初始 64×64 特征图时,难以建立大跨度的远程语义关联。
- 特征断层:高层特征在追求分辨率时,往往无法完美继承底层的深层语义,导致生成的物体(如羊、风筝)与文字背景产生视觉冲突或错位。
2. 核心架构:SAF-GAN 的进化之道
SAF-GAN 在经典层级式架构的基础上,通过“自监督模块”增强特征源头,通过“特征融合”稳固生成链路。
2.1 CotNet 自监督模块:挖掘上下文的潜力
传统的 Self-Attention 对 Q、K 进行点积运算,认为各空间位置是独立的。SAF-GAN 引入了 CotNet 模块,它通过 3x3 卷积获取局部静态上下文 ,并将其与 Query 拼接后通过两次 1x1 卷积动态生成注意力矩阵。其核心逻辑在于:利用特征间的上下文关系引导动态注意矩阵。
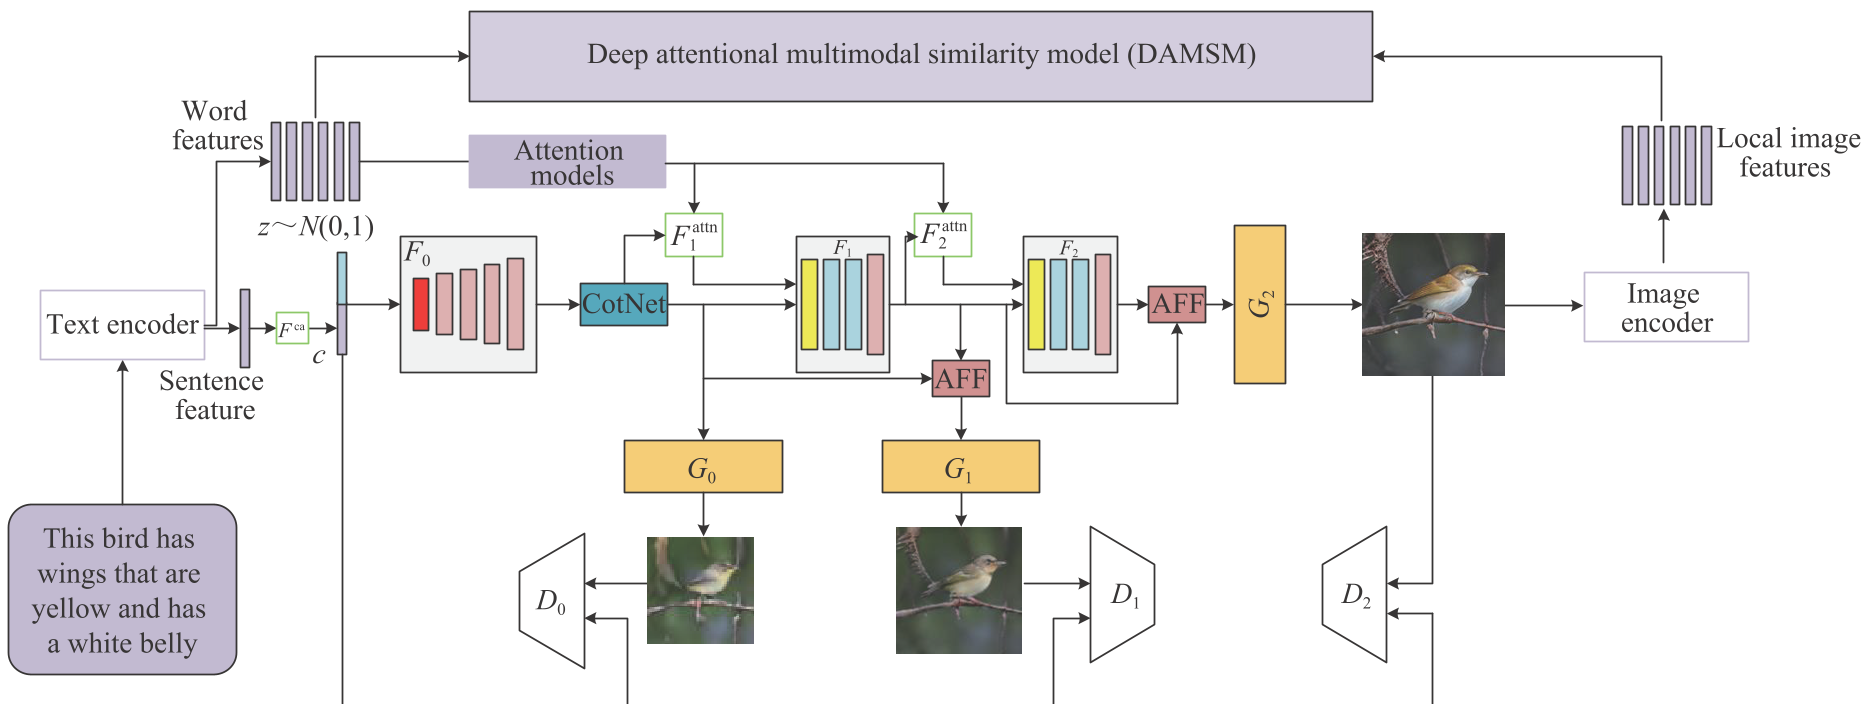
2.2 多分辨率特征融合 (AFF)
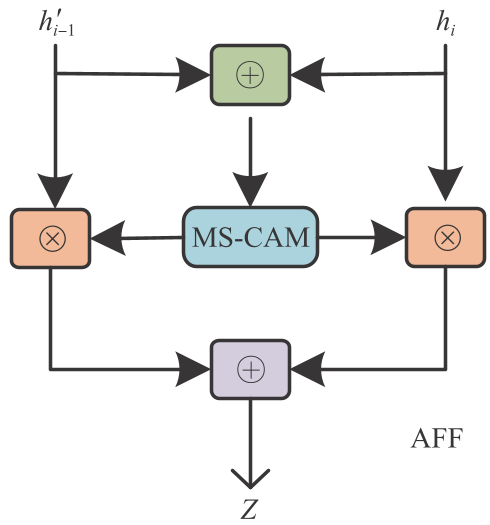
该模块不再盲目地将上下层特征相加。它采用 MS-CAM(多尺度通道注意力) 机制,如下图所示。模型能在全局和局部两个通道分支上自主决定“取舍”多少语义或细节信息,从而保证了从 64x64 到 256x256 跨越时,图像的色彩和结构不会跑偏。
3. 实验战绩:精度与视觉的双重提升
3.1 定量评估
在严苛的 COCO 数据集对比中,SAF-GAN 的 FID 指标(越低越好)降至 30.31,优于经典的 CSM-GAN 和基准模型 AttnGAN。这说明 SAF-GAN 生成的图像在分布上更接近真实照片。
| 模型 | CUB (IS↑) | CUB (FID↓) | COCO (IS↑) | COCO (FID↓) |
|---|---|---|---|---|
| AttnGAN | 4.36 | 21.48 | 25.85 | 35.49 |
| SAF-GAN | 4.67 | 18.03 | 28.53 | 30.31 |
3.2 定性可视化对比
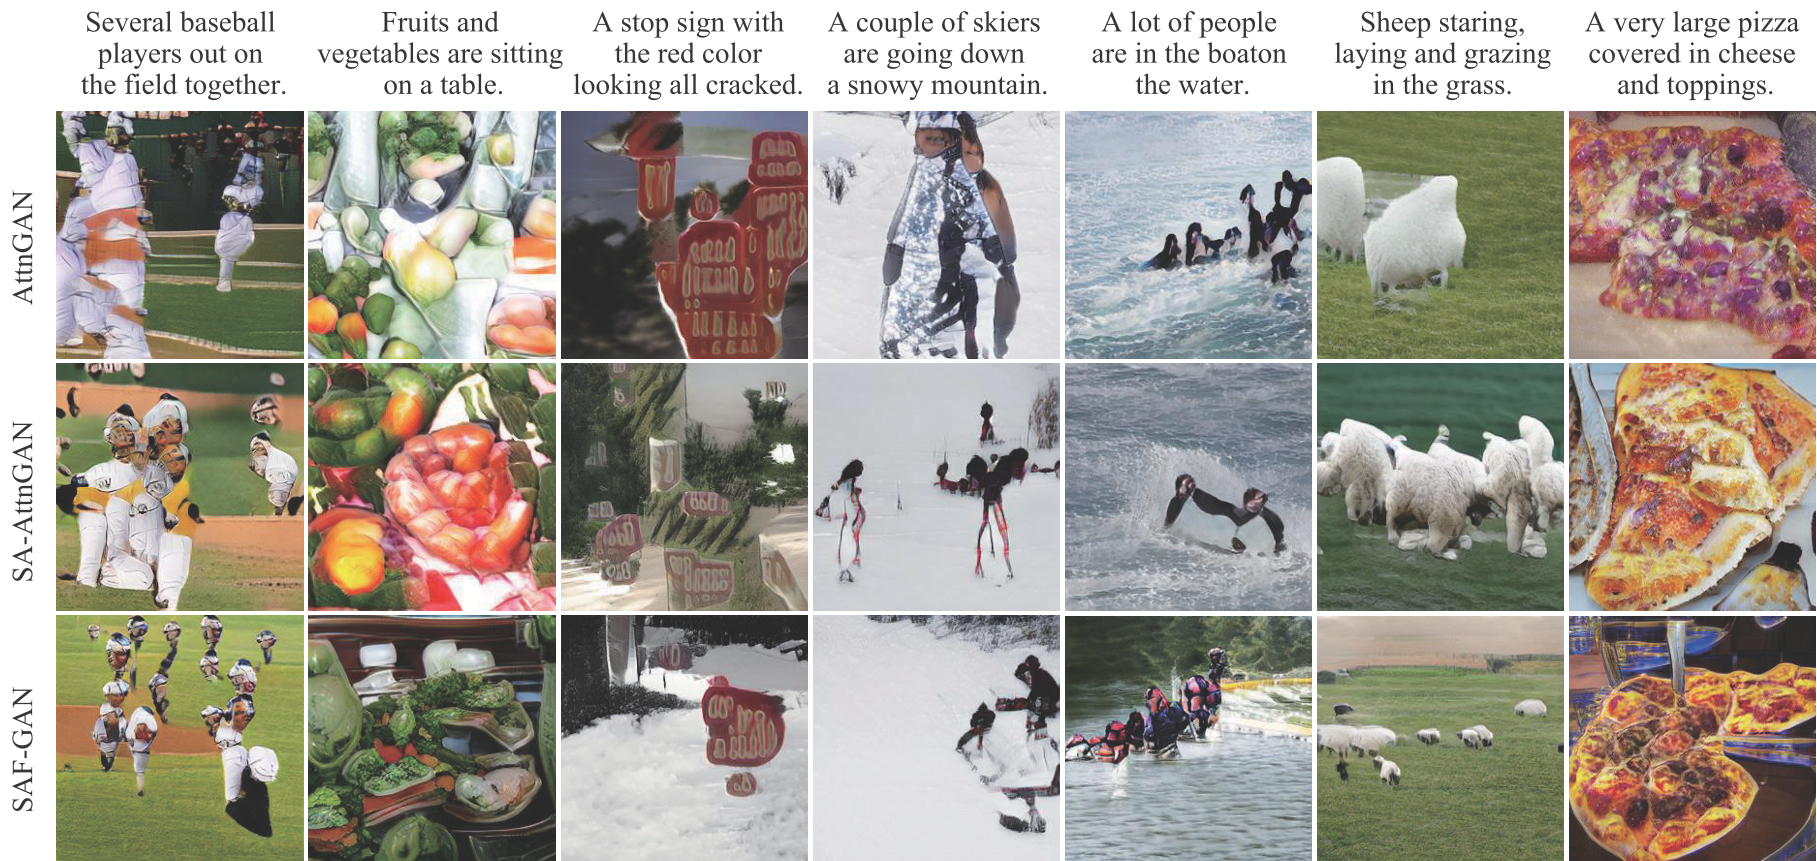
从下图实验对比中可以清晰发现:
- AttnGAN 生成的羊只往往轮廓模糊甚至重影。
- SAF-GAN 生成的对象(如第六幅中的羊)不仅轮廓清晰,且能以更有意义的方式排列场景内容,这得益于自监督模块提供的强力全局结构约束。
4. 深度洞察:为什么这种组合有效?
SAF-GAN 的成功在于它精准捕捉了 T2I 任务中的 Inductive Bias(归纳偏置)。
- 初始特征是灵魂:CotNet 在低分辨率阶段就锚定了物体的基本骨架。正如消融实验所示,仅添加 CotNet 就能让 CUB 的 FID 从 21.48 骤降至 19.47。
- 融合是护航:如果没有 AFF 模块,后期的高分辨率生成更像是“无根之木”,容易在细节添加中迷失方向。通过多尺度通道注意力,模型学会了如何优雅地将文本语义“嵌”进高分辨率的像素格中。
总结
SAF-GAN 不仅仅是对 AttnGAN 的修修补补,它实质上是在探讨如何通过上下文挖掘和动态注意力机制来弥补传统卷积在处理复杂跨模态任务时的天然短板。对于关注低资源环境下提升 GAN 生成质量的研究者来说,这种“自监督+特征融合”的思路具有极高的参考价值。