
PaSaMaster:终结学术搜索幻觉,以 1% 成本超越 GPT-5.2 的自我进化检索器
Towards Self-Evolving Agentic Literature Retrieval
本文推出了 PaSaMaster,一个专为复杂科研检索任务设计的自我进化智能型文献检索系统。该系统通过异步的“计划-检索-排序”流程,在 PaSaMaster-Bench 跨 38 个学科的测试中,将传统检索的 F1 分数提升了 15.6 倍,并实现了零幻觉推荐。
TL;DR
在学术研究的起点——文献调研中,我们常被两种极端困扰:要么是 Google Scholar 这种搜不到深层意图的“呆板”关键词工具,要么是 GPT-4/5 这种可能随口“编造”不存在论文的“大忽悠”。上海交通大学等机构的研究团队推出了 PaSaMaster,这是一种 Level 4 级别的自我进化智能检索系统。它不仅实现了 0 幻觉,还在 F1 指标上超越 GPT-5.2 达 30%,且成本仅需后者的百分之一。
1. 痛点:为何学术搜索如此难做?
传统的文献检索存在一个“不可能三角”:深度意图理解、来源真实性和计算成本。
- 关键词搜索 (Level 0/1):必须输入精准术语,无法处理类似“帮我找几篇用过图神经网络但在流体力学领域解决湍流问题的 2020 年后的论文”这种复杂请求。
- 生成式大模型 (Level 2):理解力满分,但其“概率预测”的本质导致它会根据关联性拼凑论文标题和作者,产生学术界的“数字伪证”。文中实测 GPT-5.2 的幻觉率仍有 11.8%,而某些模型甚至接近 38%。
2. 核心机理:Navigator 与 Librarian 的双人舞
PaSaMaster 抛弃了“一次性生成结果”的逻辑,将其重构为一个自我进化的迭代过程过程。
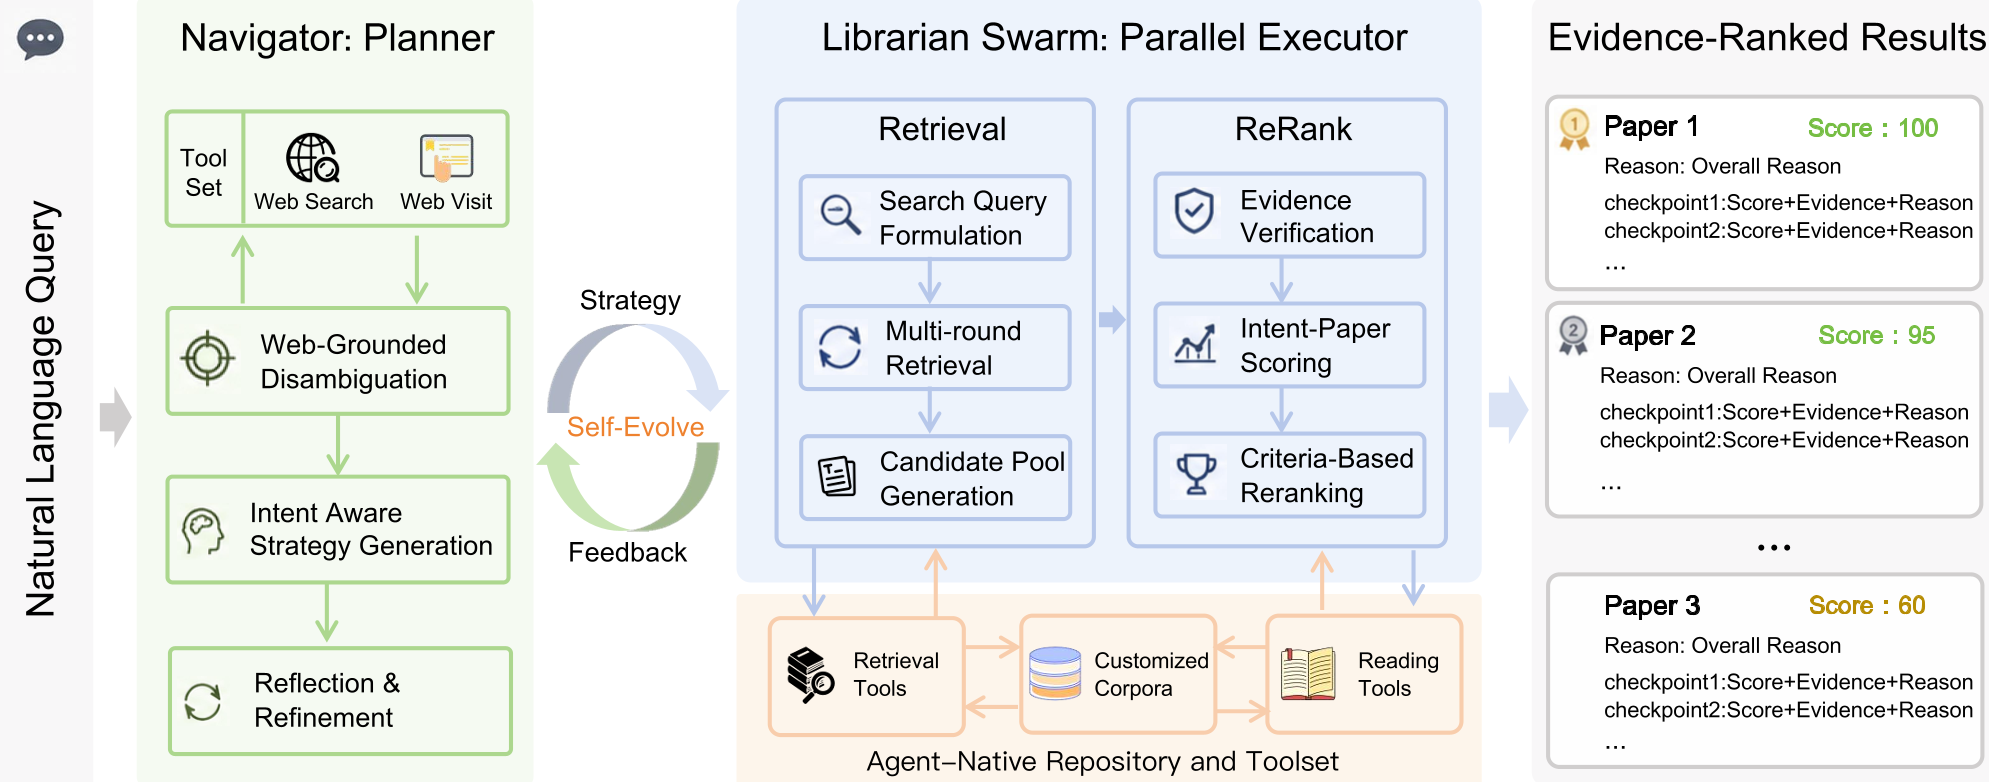
2.1 规划与检索的分离 (Separation of Planning & Retrieval)
系统将任务拆分为两个角色:
- Navigator (导航员):由顶级 LLM(如 GPT-4 等级)担任。它不负责查书,只负责理解用户的复杂意图,生成检索策略(Strategy)和验证清单(Checklist)。
- Librarian Swarm (馆员集群):由经过知识蒸馏的轻量化模型组成。它们负责在包含 1.6 亿篇论文的本地化数据库中进行大规模的 Embedding 搜索和事实比对。
2.2 自我进化环路 (Self-Evolving Loop)
与众不同的是,PaSaMaster 在第一轮检索后,Navigator 会检视结果:有哪些约束还没满足?哪些方向搜偏了?随后自动调整参数进行第二轮、第三轮搜索。这种 Reflect (反射) 机制让系统能够像人类专家一样不断修正搜索范围。
3. 拒绝幻觉:基于证据的评分 (Evidence-Grounded Scoring)
为了确保每一条推荐都真实可靠,PaSaMaster 建立了一个三层仓库:Metadata(元数据)、Abstract(摘要)和 Chunk(正文文本块)。
系统对每篇论文的判定不是模糊的“相关”,而是根据验证清单逐项打分:
- 定位证据块:从论文正文中提取最相关的片段。
- Scorer 定权:轻量级 Scorer 模型根据证据块给出 1-5 分的满意度。
- 计算概率:结合模型的置信度(Calibration)输出最终排名。 这种“先查证,后列名”的流程从根本上杜绝了生成式幻觉。
4. 实验战绩:高效率下的降维打击
研究团队构建了 PaSaMaster-Bench,涵盖 38 个学科及 244 个极具挑战性的专家级查询任务。
4.1 性能对比
根据实验数据(如下表所示),PaSaMaster 在 F1-score 和 NDCG(排序质量)上均表现出压倒性优势。
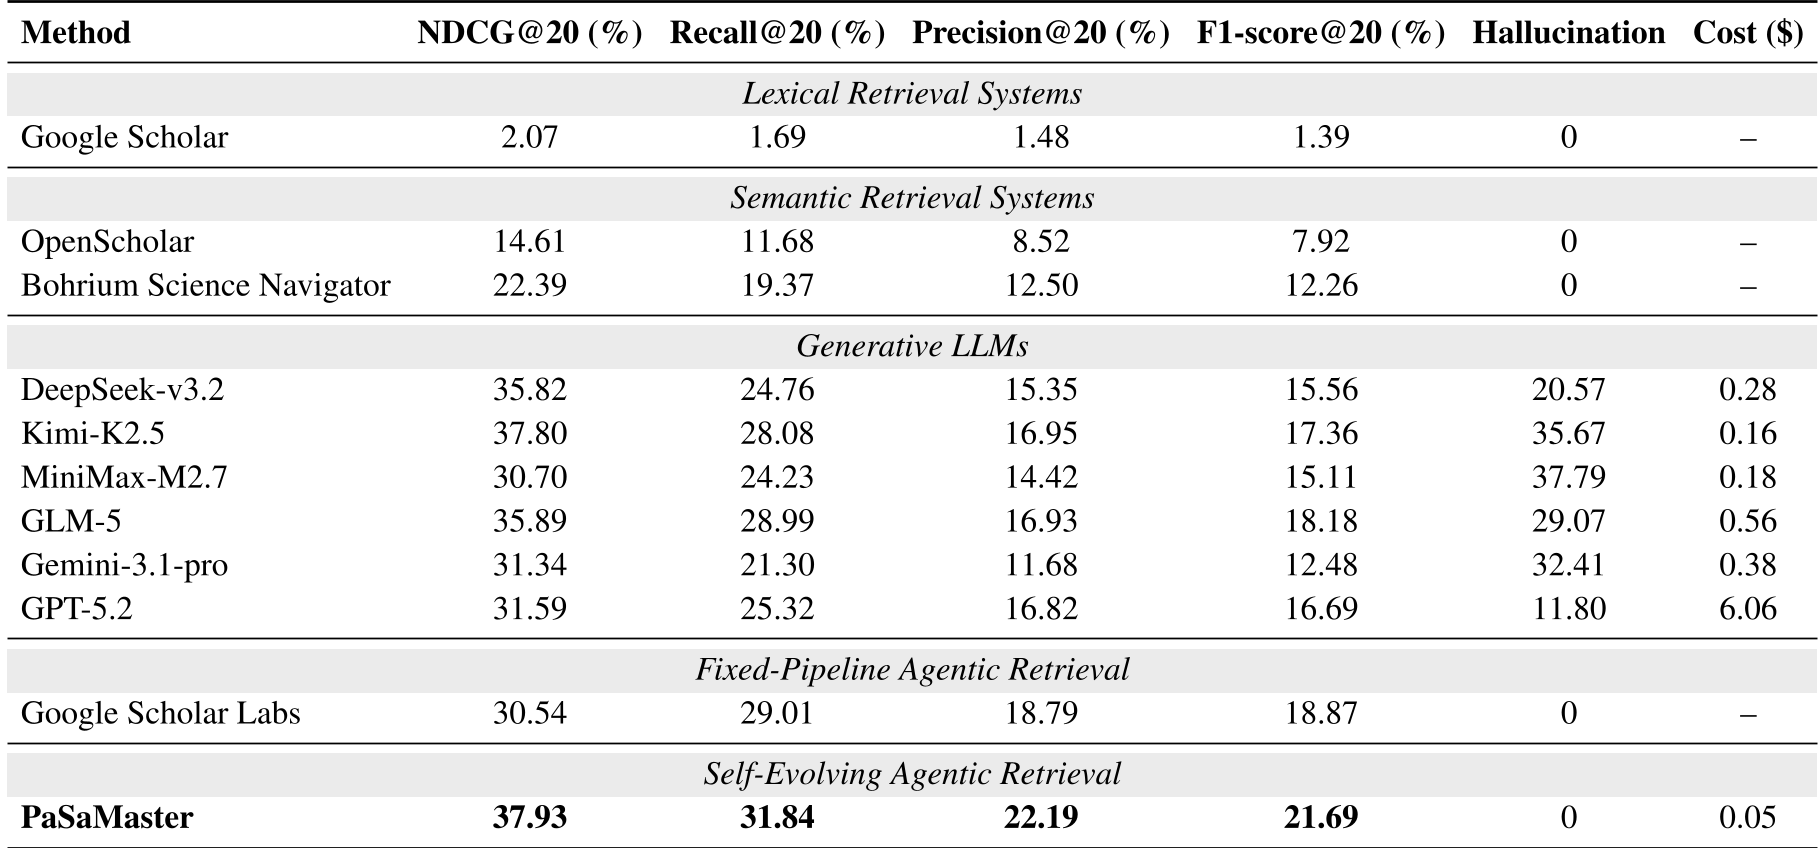
- VS 传统检索:F1 分数提升了 15.6 倍。
- VS GPT-5.2:F1 分数领先 30%,且 GPT-5.2 每次查询成本约 0.05**。
- 幻觉率:PaSaMaster 依然维持在完美的 0% 幻觉,而所有生成式模型(包括最近的 Kimi-K2.5, DeepSeek-v3.2)均无法避免虚假引用的问题。
5. 总结与启示
PaSaMaster 的成功标志着学术检索进入了 Agentic(智能体化) 时代。它告诉我们:
- 不要让 LLM 做它不擅长的事:把“记忆和生成”交给数据库和检索器,把“逻辑和反思”交给 LLM。
- 反馈比容量更重要:通过多轮迭代的闭环,小规模参数的系统也能在特定任务上击败昂贵的万亿级模型。
这种低成本、高可靠的检索技术,不仅是科研人员的福音,也将为法律、医疗等对事实准确性有着“零容忍”要求的垂直行业提供极具价值的范式参考。