
OpenDeepThink:超越单路径推理,基于 Bradley–Terry 聚合的并行演算新范式
OpenDeepThink: Parallel Reasoning via Bradley–Terry Aggregation
本文提出了 OpenDeepThink,一种基于群体演化的并行测试时计算(Test-time Compute)框架。该方法放弃了传统的单路径推理扩展,转而通过并行采样、基于 Bradley–Terry (BT) 模型的两两对比排名以及反馈驱动的变异来协同优化解集,在无需外部验证器的情况下显著提升了 LLM 的复杂推理能力。
TL;DR
在推理模型(Reasoning Models)如 o1 和 DeepSeek-R1 开启的“测试时计算扩展(Test-time Compute Scaling)”浪潮中,主流做法是无限延长思维链(CoT)的深度。然而,OpenDeepThink 另辟蹊径,证明了“宽度”与“演化”同样强大。它通过一种无需外部验证器的群体演化机制,利用 Bradley–Terry 模型聚合两两对比信息,将 Gemini 3.1 Pro 的编程竞赛 Elo 分数暴力拉升了 405 分。
1. 痛点:单路径的“脆弱”与点分的“偏见”
目前大模型处理复杂问题(如 Codeforces 竞赛题)主要面临两个瓶颈:
- 深度瓶颈 (Depth Logic):现有的推理模型倾向于生成极长的单条路径,一旦推理早期出现“幻觉”或逻辑断裂,后续的所有计算资源都会被浪费。
- 筛选瓶颈 (Selection Bottleneck):如果我们并行采样 100 个结果(Best-of-100),怎么选出对的那个?在没有编译器或测试用例的环境下,让 LLM 直接给每个解打分(Pointwise Scoring)极其不准,它往往会表现出严重的自恋偏见和评分漂移。
2. 核心直觉:从“绝对评分”转向“相对竞技”
作者的灵感源于 Chatbot Arena。人类很难给一个模型打出绝对精准的分数,但很容易判断 A 是否比 B 好。 OpenDeepThink 将这种“两两对比(Pairwise Comparison)”机制引入了推理过程。相比于点分模式,两两对比可以将判别准确率从 59% 提升至 86%。
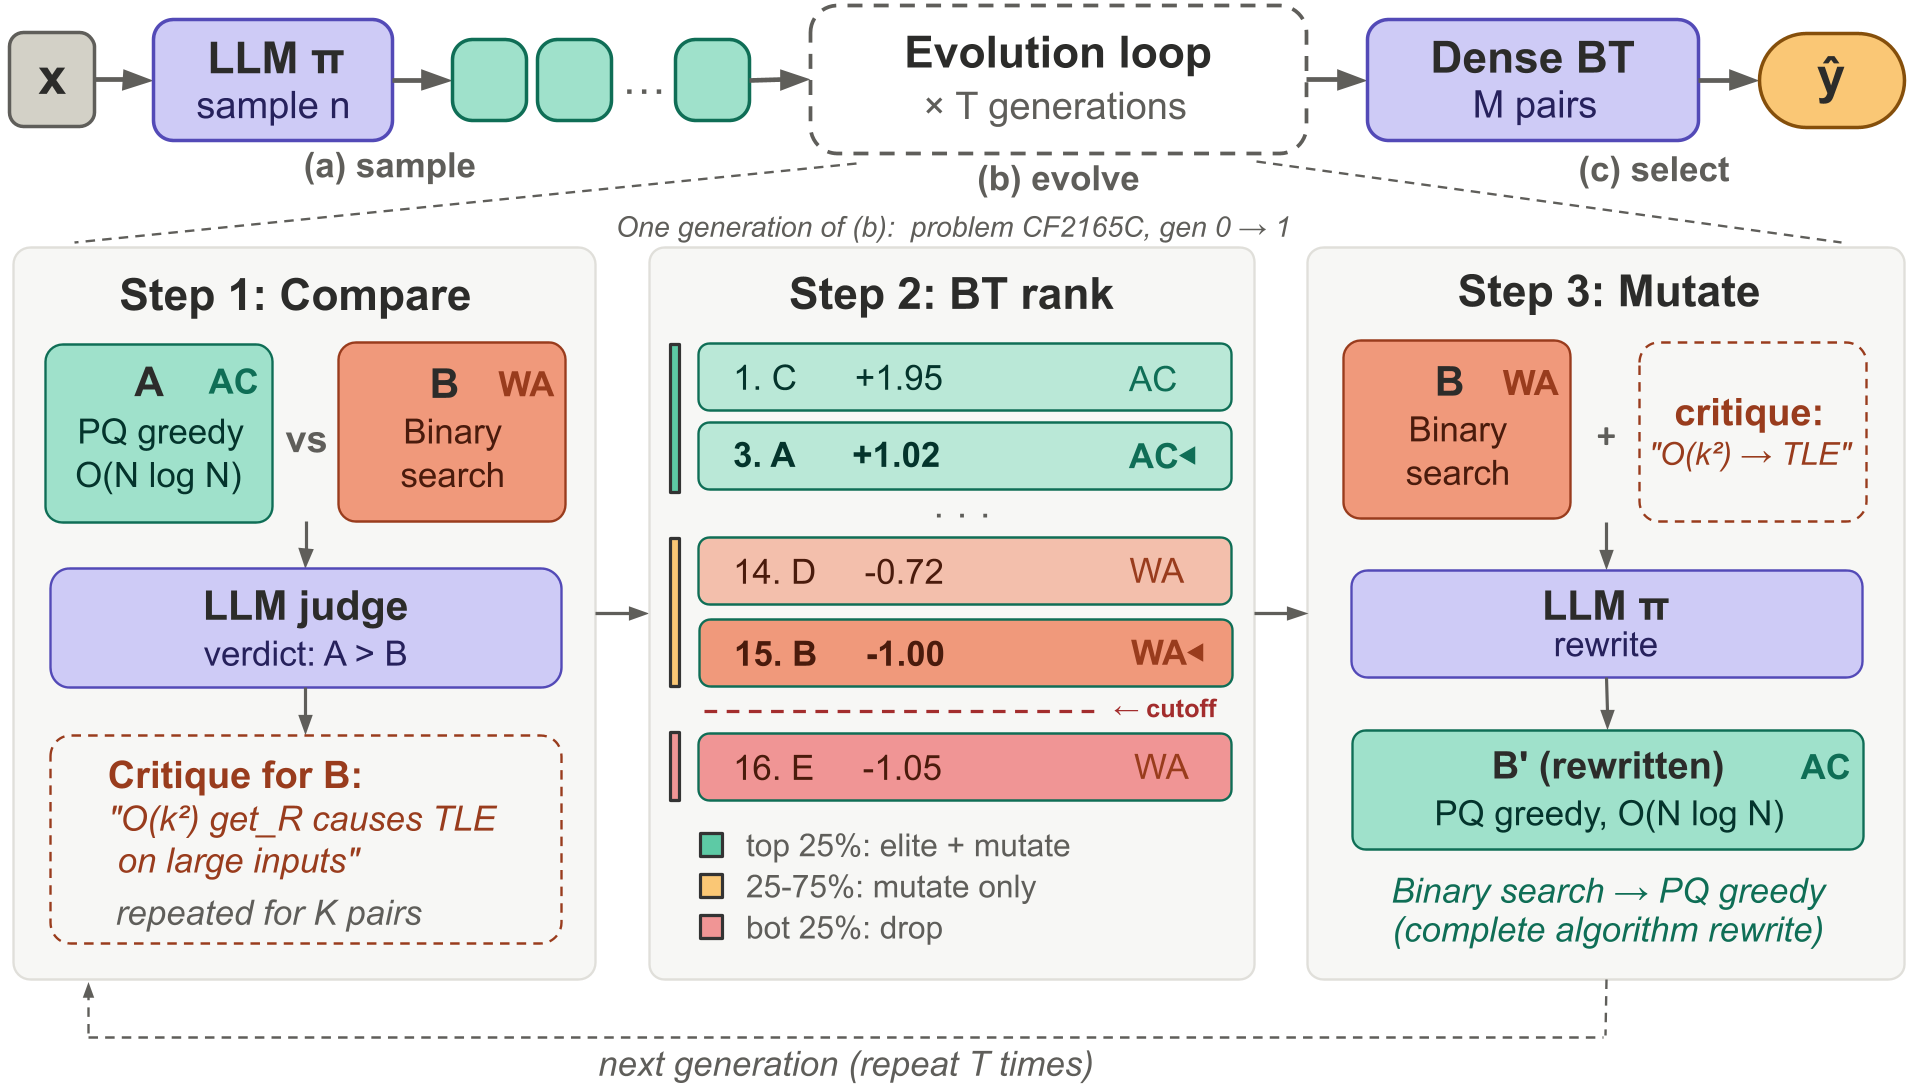 图 1: OpenDeepThink 的演化循环,包含并行采样、BT 聚合排名、精英保留与反馈变异。
3. 算法解析:群体演化的三步走
OpenDeepThink 的核心是一个 T 轮的演化循环(通常 T=3),每轮包含以下三个关键环节:
3.1 Bradley–Terry 聚合排名
系统让 LLM 对候选池中的解进行随机两两对决。为了消除位置偏见,对比顺序是随机的。关键在于 Bradley–Terry (BT) 模型 的引入: 通过极大似然估计,将这些杂乱的局部胜负关系转化为全局唯一的“能力值”评分 。这套机制能够自动内化“对手的强度”,即使某个解只参加了少量对比,其评分也比单纯的胜率更具代表性。
3.2 负反馈驱动的定向变异
在对比过程中,LLM 裁判不仅给出胜负,还会写下“为什么 A 比 B 好”的自然语言反馈。
- 精英保护:Top 25% 的解直接进入下一轮。
- 定向突变:Top 75% 的解(含精英)依据对比中得到的“负面反馈”进行重写。
- 推翻重做:提示词允许模型完全抛弃当前思路。实验发现,负面反馈(指出哪里错了) 提供的信号是变异成功的关键,而正面反馈几乎没有贡献。
3.3 串行深度的极致优化
尽管整个流程调用了约 285 次 API,但由于每一轮内的对比和变异都是高度并行的,其实际的串行深度仅为 8 次 LLM 调用。这意味着在 27 分钟内,你可以通过增加机器并发来换取极高的逻辑质量。
4. 实验战果:刷榜 Codeforces 与跨领域表现
在最具挑战性的 Hard 级别编程题(Pass@1 低于 35% 的题目)中,OpenDeepThink 展现出了惊人的增长曲线:
- 采样覆盖度:通过演化,pool 中出现正确答案的概率从 11% 提升到 36%。
- 筛选精度:BT 模型选出的解(Final Top-1)准确率达到了 50%。
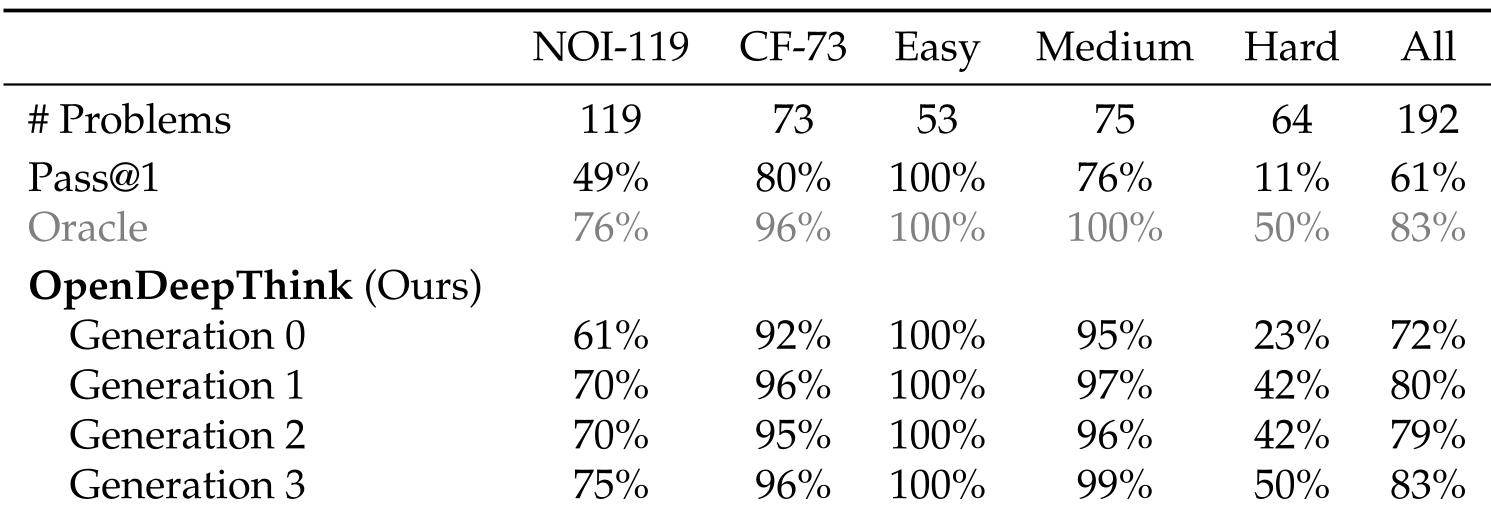 表 1: 在 NOI 和 Codeforces 上的表现。可以看到 Hard 题目的提升最为显著。
有趣的发现: 在 HLE(Humanity's Last Exam)这种跨学科测试中,作者发现:在具有客观标准(数学、物理、生物)的领域,该方法大幅提分;但在主观性强(人文、社科)的领域,效果反而会下降。这说明 “软验证器”的效果上限取决于 LLM 裁判的判识客观性。
5. 深度洞察
- Selection Is All You Need:实验证明,即便不进行演化变异,仅仅用 BT 聚合在原始采样池里选妃,准确率也远超点分 Baseline。这敲响了 Pointwise LLM-as-a-judge 的丧钟。
- 演化的前置效应:大部分的性能提升发生在第一轮变异(Gen-0 -> Gen-1)。后续的轮数主要在于通过密集的 BT 对比挤出余下的精度水分。
- 无缝迁移:该框架具有极强的普适性。Gemini 3 Flash 配合 OpenDeepThink 竟然能展现出追赶 Pro 模型的推理潜力。
6. 总结与反思
OpenDeepThink 提供了一种“以算力换智力”的新路径。它不要求你拥有完美的奖励模型(Reward Model),也不需要昂贵的 RL 训练。只要你有足够的 API 并发额度,就能通过这个“并行演算沙盒”让普通的 LLM 进化出奥林匹克级别的推理能力。
局限性:每道题 285 次的 API 调用成本依然高昂。未来的方向可能是将这种并行搜索产生的优质轨迹通过冷启动数据回馈给模型进行蒸馏,实现“计算量下降,智力留存”。