
OpenDebateEvidence:350万辩论文本重塑 LLM 的“抬杠”与深度论证能力
OpenDebateEvidence: A Massive-Scale Argument Mining and Summarization Dataset
本文推出了 OpenDebateEvidence,这是一个源自美国高水平竞争性辩论社区的超大规模论点挖掘与论证性摘要(Argumentative Summarization)数据集,包含超过 350 万份具有丰富元数据的文档。通过在此数据集上对 LLaMA3-70B 等大语言模型进行 LoRA 和 ReFT 微调,该工作在多项逻辑论证与摘要基准上刷新了 SOTA 性能。
TL;DR
在传统的自然语言处理(NLP)领域,文本摘要往往追求客观与中立。然而,在真实世界的决策、法律抗辩和商业谈判中,**带有强烈修辞偏向(Biased)、策略性构架(Strategic Structuring)以及层级支撑的论证性摘要(Argumentative Summarization)**才是高级心智的体现。
本文介绍由 Wand.AI、纽约大学、斯坦福大学及加州大学伯克利分校等机构联合发表在 arXiv 2026 的力作:《OpenDebateEvidence: A Massive-Scale Argument Mining and Summarization Dataset》。该研究从美国高水平竞争性辩论社区(Policy, LD, Public Forum)中挖掘并清洗出了包含 **350 万份文档(共计 480 万行)**的超大规模论点挖掘与摘要数据集,并开源了包含 25 个高维度 LLM 标注的 argument-quality 变体,彻底刷新了 LLM 在高难度策略论证任务上的表现。
痛点深挖:通用摘要饱汉不知饿汉饥,辩论 AI “无米下锅”
在论点挖掘(Argument Mining)的学术坐标系中,前人的工作面临两大硬伤:
- 规模极其有限且场景单一:此前最常用的辩论数据集
DebateSum(由本研究部分作者于 2020 年推出)仅包含 24 万个样本,且主要聚焦于“季前夏令营(Pre-season)”的材料,完全缺失了常规赛季中极具动态对抗性的论证。其他诸如VivesDebate、ArgAnalysis35K等数据集,样本量大都在 1,000 到 10,000 级徘徊,根本无法喂饱如今动辄数十亿参数的 LLM。 - 修辞与策略性特征被抹平:像
BillSum(立法摘要)和xSum(新闻单句摘要)这类传统数据集,强调的是绝对客观中立。而在真实辩论中,选手会先入为主地确立一个“Tag”(带有偏向性的核心论点断言),然后寻找对应的证据卡片(Cards),并用**下划线(Underlining)和高亮(Highlighting)**对原文进行选择性截断阅读(Spoken text)。通用数据集完全丧失了这种“论断-选择性证据-完整上下文”的修辞张力。
为了解决这一痛点,作者将目光投向了美国辩论界的开源宝库 —— OpenCaseList。
方法论详解:从 Docx 到结构化 XML 的炼金术
辩论证据(Debate Evidence)通常以 .docx 格式保存在选手的电脑中,排版复杂,夹杂了各种自定义下划线、粗体和高亮。为了将其转化为机器可理解的高质量语料,作者构建了一套严密的解析与增强管线:
1. 格式感知的解析管线(Formatting-Aware Parsing)
解析器首先解包 .docx 以获取内部 XML 树,绝不粗暴丢弃排版信息。因为在辩论中,下划线代表了“文字级抽取式摘要(Extractive Summary)”,而高亮部分则是辩论中实际读出来的“Spoken”文本。
- Pocket(口袋):顶级段落分类(例如
1NC- 第一次否定建设性发言)。 - Hat(帽子):中级论点大类(例如
Capitalism Critique- 资本主义批判)。 - Tag(标签):选手人工撰写的极度浓缩、带修辞偏向的抽象摘要(例如 “资本积累导致生物圈崩溃和人类灭绝”)。
通过保留这些标记,数据集天然形成了“一节多用”的多层级摘要基准。
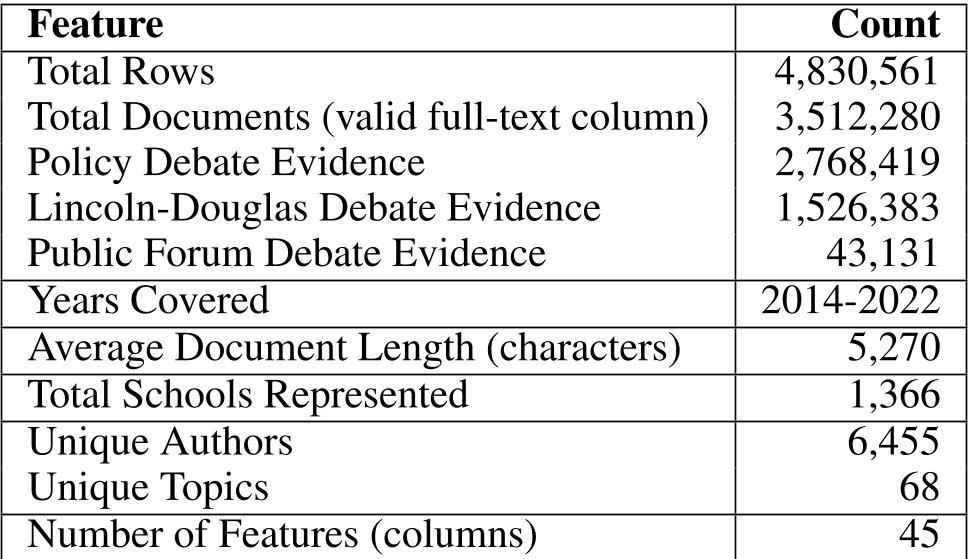 Table 1:OpenDebateEvidence 数据集的核心统计数据
2. 双重去重机制:语义与传统的碰撞
辩论赛中,不同的队伍会使用完全相同的“证据卡(Cards)”,但这往往伴随不同的偏向性 Tag。
- 字面去重:清洗非字母字符、小写化,通过计算共享句子数剔除字面重复。
- 神经语义去重(Neural Semantic Deduplication):利用中高等级向量模型
gte-base-en-v1.5计算嵌入余弦相似度,相似度超过 0.95 的近重复卡片被合并或剔除,最终保留了最独特的 75.6 万行高质量学术论据。
3. 高级玩法:25 个维度的“Annotated”专家变体
为了让 LLM 真正理解什么是“好论据”,作者对 85,600 张卡片进行了基于大模型的受约束类型标注(Constrained Schema Annotation)。这 25 个特征分为七大群组,将辩论领域的隐性专家知识(Expertise)显性化:
- 核心分析(Core Analysis):作者公信力、证据类型(经验、专家观点等)。
- 方法论评估(Methodological Assessment):样本量是否充足、数据时效性。
- 论证属性(Argumentative Properties):论证强度(Warrant Strength)、抗辩抵抗力、影响范围(Scope of Impact)。
- 战略价值(Strategic Value):进攻价值(Offensive Value)、防御价值、独特性。
这使得该变体成为研究“论证质量评估”和“可控策略检索”的绝佳基准。
实验与结果:LLaMA3-70B + LoRA 的降维打击
作者在 OpenDebateEvidence、DebateSum、BillSum 以及非对抗性的新闻摘要数据集 xSum 上,测试了包括 Mistral-7B、LLaMA3-8B、LLaMA3-70B 在内的多种开源模型,并与 Gemini 和 Claude 等商业闭源 API 进行了对比。
微调技术采用了三种高效方案:LoRA、ReFT(Representation Fine-Tuning) 以及 Orthogonalization(正交化修正)。
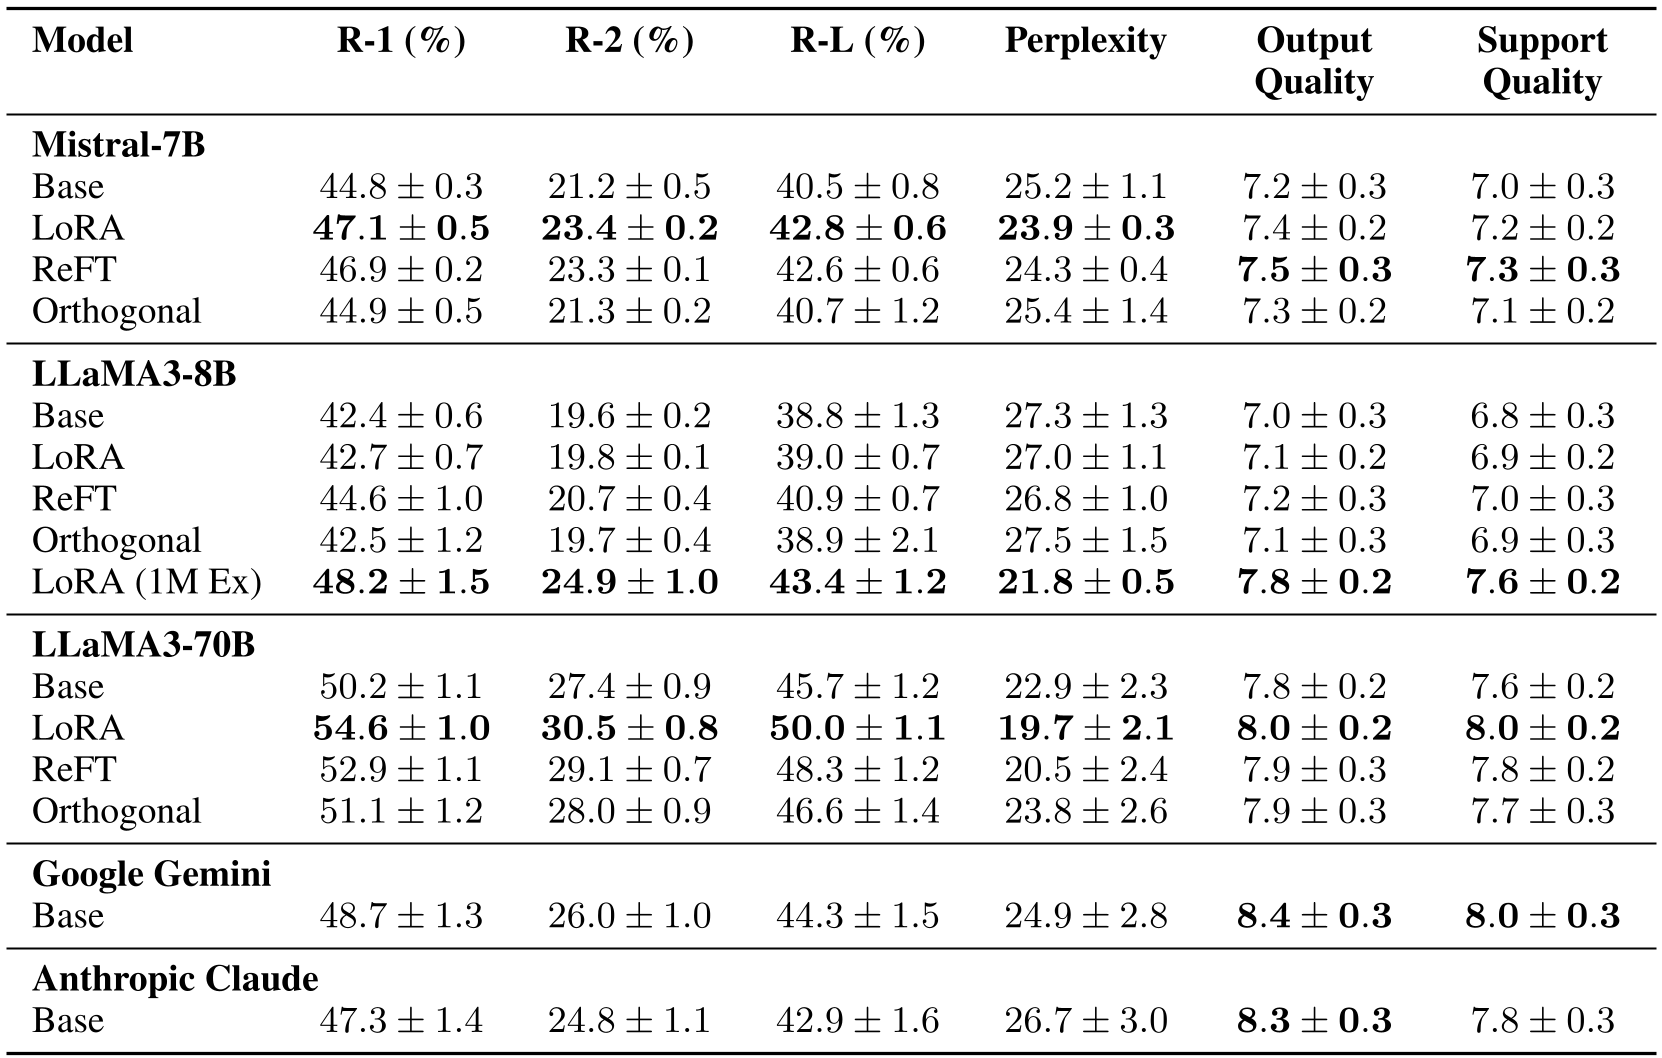 Table 3:模型在 BillSum 数据集上的表现
核心实验结论:
- 尺寸即正义:在所有实验中,LLaMA3-70B 展现出了对复杂逻辑文本的压倒性理解力。
- LoRA 夺冠,ReFT 紧随其后:如 Table 3 所示,在立法摘要任务(BillSum)上,经过 LoRA 微调的 LLaMA3-70B 取得了最高的 ROUGE F1 分数(R-1: 54.6%, R-2: 30.5%, R-L: 50.0%),且困惑度(Perplexity)被压制到了惊人的 19.7。这甚至击败了直接调用 Base 版的 Google Gemini(R-1: 48.7%)和 Anthropic Claude(R-1: 47.3%)。
- 强大的迁移与预训练红利:将模型在该数据集上进行第一阶段预训练(Pre-training),再在下游特定任务(如法律多文档摘要 Multi-LexSum)上微调,可以使模型的困惑度降低 60% 以上,且生成的摘要在“Support Quality”(证据支持度评价)上显著获得更高分。
深度洞察与伦理纠纷:一份关乎隐私的 2026 重构思考
本论文不仅在技术上可圈可点,其背后的一段真实隐私纠纷更是堪称机器学习领域的经典教案。
“马赛克效应(Mosaic Effect)”的教训
2026 年 5 月末,Hugging Face 曾下架了该数据集的 2024 初始版本。原因在于,虽然作者当时对辩手姓名做了 cosmetical(化妆式)截断(如 Aaron Ki*** 截断为 Aa*** Ki***),但遗留的 filePath 字段(例如 ./documents/ndtceda15/Army/JoSo/Army-Johnson-Sowatzke-Aff-Round1.docx)却完整保留了辩手的真实姓氏、学校和参赛记录。
这就是信息安全中的马赛克效应 —— 单个数据看似无害,但当我们将 350 万行的高校、年份、评委、对手进行关联并汇总为一个可供检索的巨型表格时,它就构成了一个实质上的“开盒”工具。
救赎与重构
在 2026 年 7 月底重新上架的最终版中,作者展现了极高的数据道德:
- 果断阉割 26 个敏感列:彻底移除了包括辩手姓名、学校名称、精确的轮次 ID、对手名称、甚至上传路径在内的 26 个元数据列。
- 文本零损耗:辩论的核心文本、学术证据卡、Tag 总结完全没有进行修改。
- 直面抗拒 AI 的辩论社群:论文坦言,辩论界有一派保守势力(出于害怕 AI 代写论文破坏研究训练而反对本项目)借由隐私漏洞发难。但作者清醒地指出,掩耳盗铃无法阻挡技术发展,OpenCaseList 的原网页数据依旧是公开的。通过剥离身份信息、保留学术语料,本项目实现了学术研究与隐私保护的精妙平衡。
局限性与未来展望
- 偏向性(Representation Bias):由于美国顶级辩论圈非常崇尚“批判理论(Critical Theory)”,数据中充斥着大量后现代主义、女权主义、批判种族理论等偏左翼的哲学卡片(Frankfurt School, Queer Theory 等)。这虽然提供了一个绝佳的批判性思维建模语料,但也可能给微调后的模型带入特定的偏见。
- 学术失信与噪音:极少数辩手可能会存在学术不端行为(如私自修改引文、篡改证据排版),作者估计这在数据集中约占万分之几。
作为资深技术主编,我认为 OpenDebateEvidence 的发布不仅填补了 NLP 社区在“策略对抗性论证”数据上的空白,更向我们展示了:如何从真实、甚至略带杂乱的垂直行业(如学术竞赛)中,压榨出能够赋能下一代 LLM 的高质量逻辑语料。对于研究智能体谈判、法律分析和可控修辞生成的学者来说,这是一个不容错过的黄金矿山。