
NER-RoBERTa:赋能低资源语言,突破库尔德语实体识别瓶颈
NER- RoBERTa: Fine-Tuning RoBERTa for Named Entity Recognition (NER) within low-resource languages
本文提出了 NER-RoBERTa,一种针对低资源语言(如库尔德语 Sorani 方言)命名的实体识别(NER)微调方法。通过构建首个标注的库尔德语 NER 数据集并引入带有 Adapter 结构的改良 RoBERTa 架构,在多项实验中刷新了该语言处理的性能标杆。
TL;DR
在自然语言处理(NLP)领域,库尔德语(Kurdish)一直被视为“数据孤岛”。受限于语料匮乏与复杂的语言结构,其命名实体识别(NER)性能长期滞后。本文通过开源首个 Sorani 方言标注数据集,并提出一种基于 Zero-initialized Attention 的改良版 RoBERTa 模型,成功将 F1 分数推至 92.9%,相比现有基线提升了 12.8%。
1. 痛点:库尔德语 NLP 的“资源荒”
库尔德语拥有数千万使用者,但在 AI 领域却处于边缘化地带。其核心挑战在于:
- 形态高度复杂:拥有多种方言(如 Kurmanji, Sorani),其语法结构与英语迥异。
- 数据集匮乏:缺乏标准化、大规模且高质量标注的 NER 语料。
- 架构不适配:如 RoBERTa 等模型原本主要针对英语训练,直接用于库尔德语(Zero-shot)时表现极差。
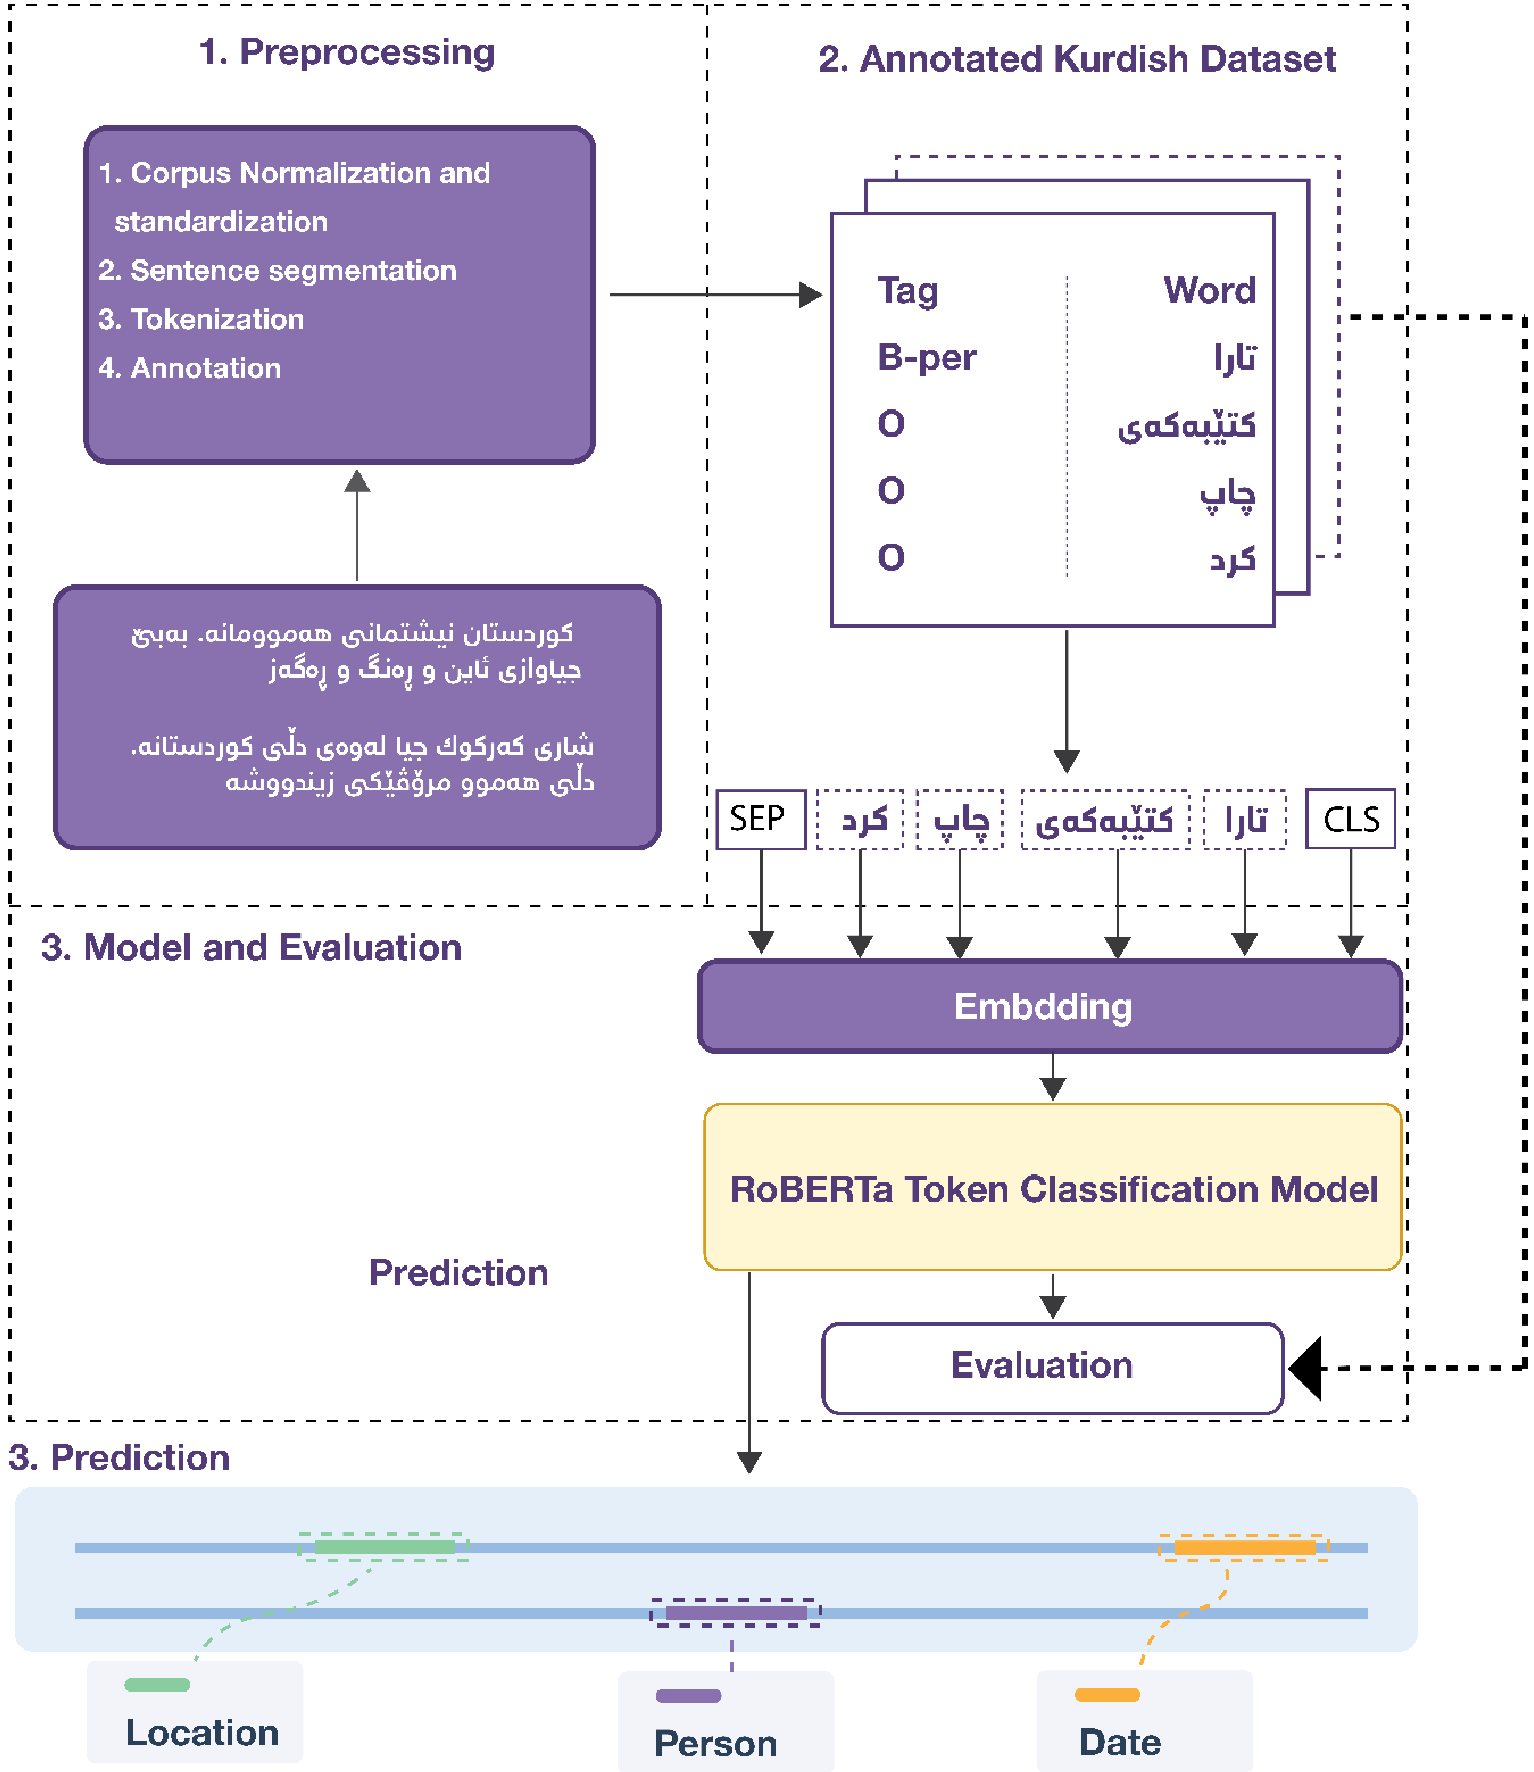
2. 核心机制:Adapter 驱动的改良架构
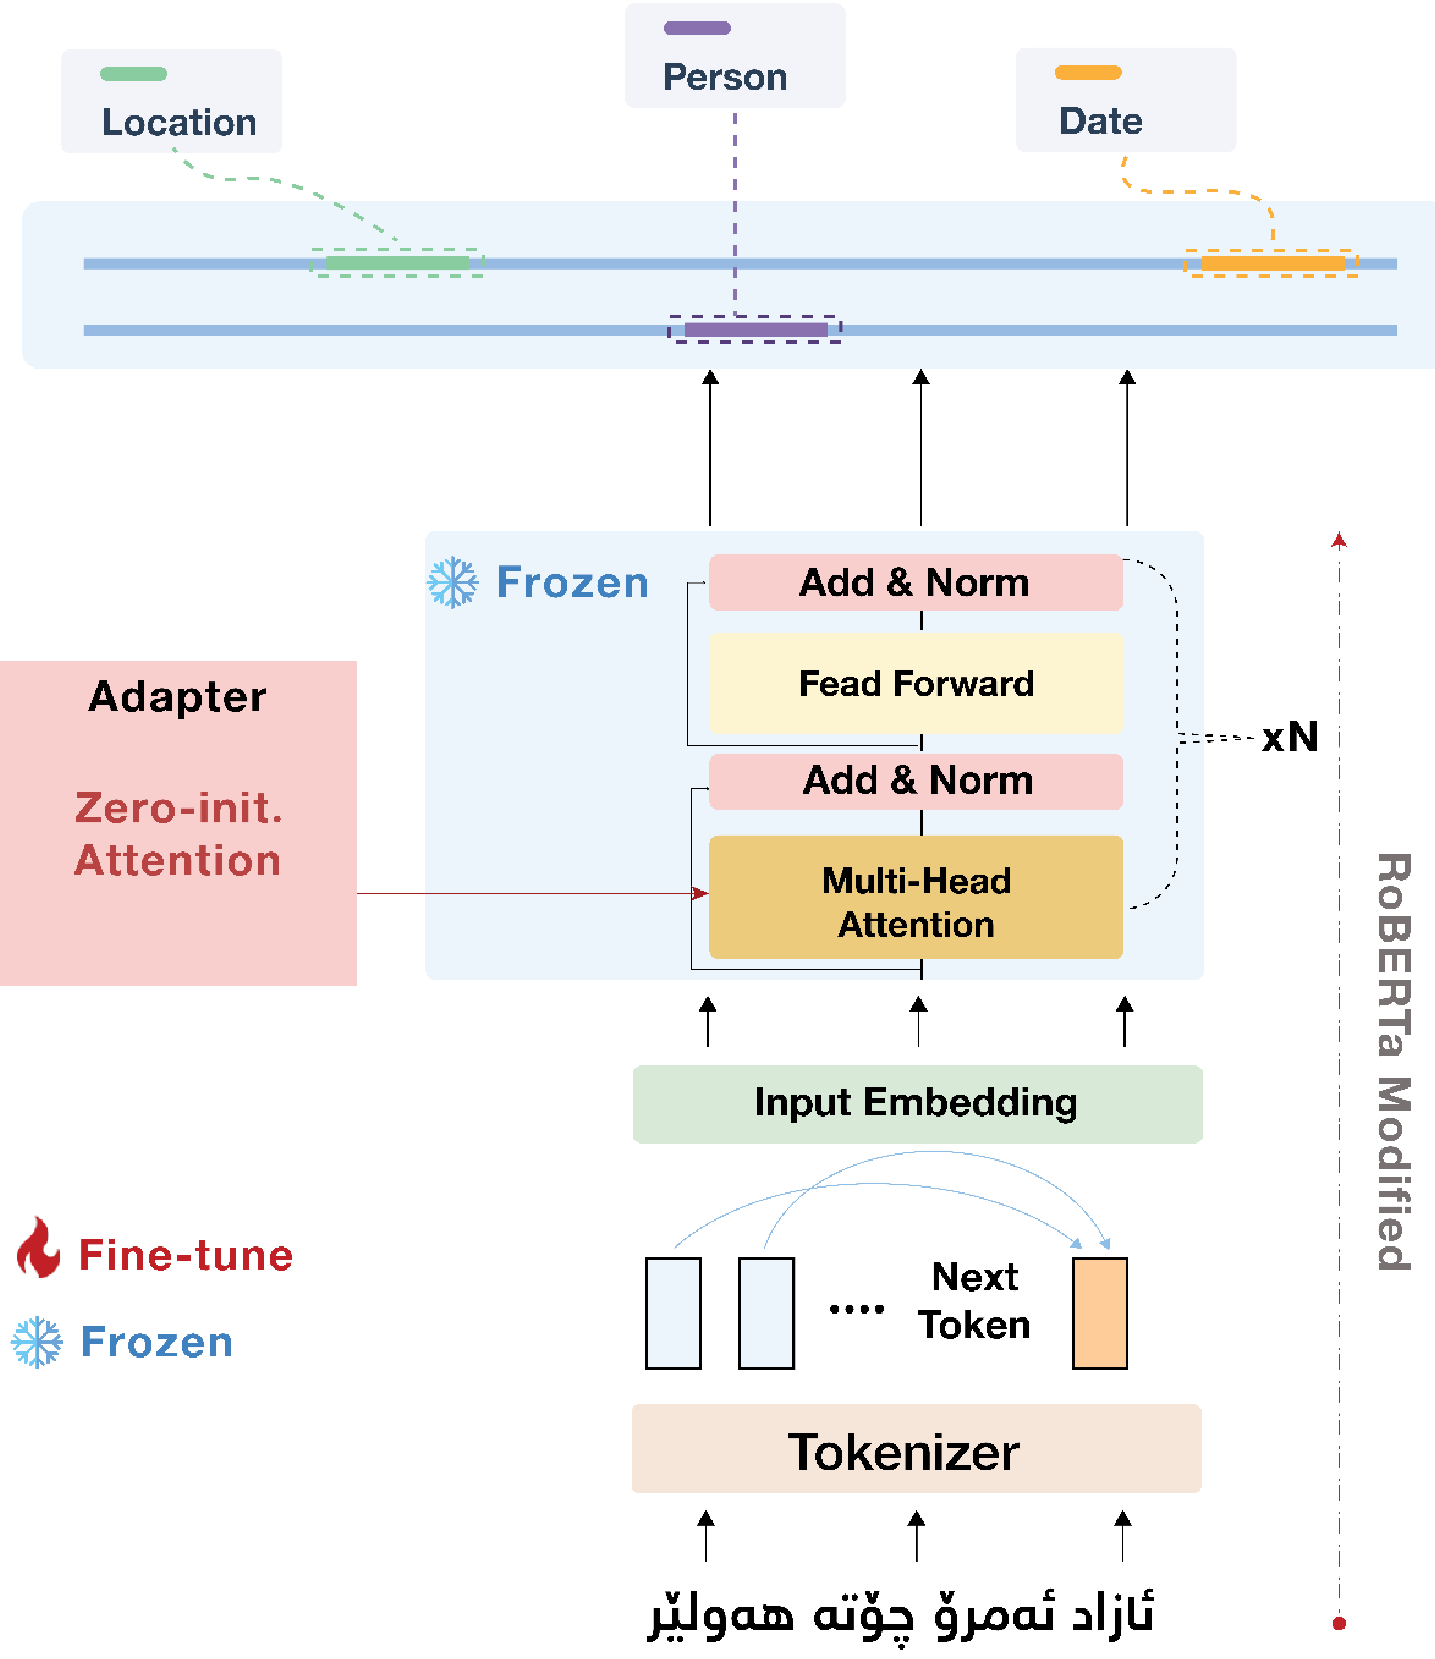
为了在极其有限的数据(约 1500 条句子)下微调大型模型而不产生过拟合,作者提出了改良的 RoBERTa 架构:
2.1 零初始化注意力(Zero-initialized Attention)
作者没有微调 RoBERTa 的所有参数,而是引入了类似于 Adapter 的模块。其数学本质是在标准多头注意力(MHA)旁路添加一个可学习层: 其中 在初期初始化为 0。这种设计的物理直觉是:在不破坏预训练模型原有的通用知识前提下,让模型像“外挂插件”一样逐渐习得库尔德语的特定模式。
2.2 关键分词策略
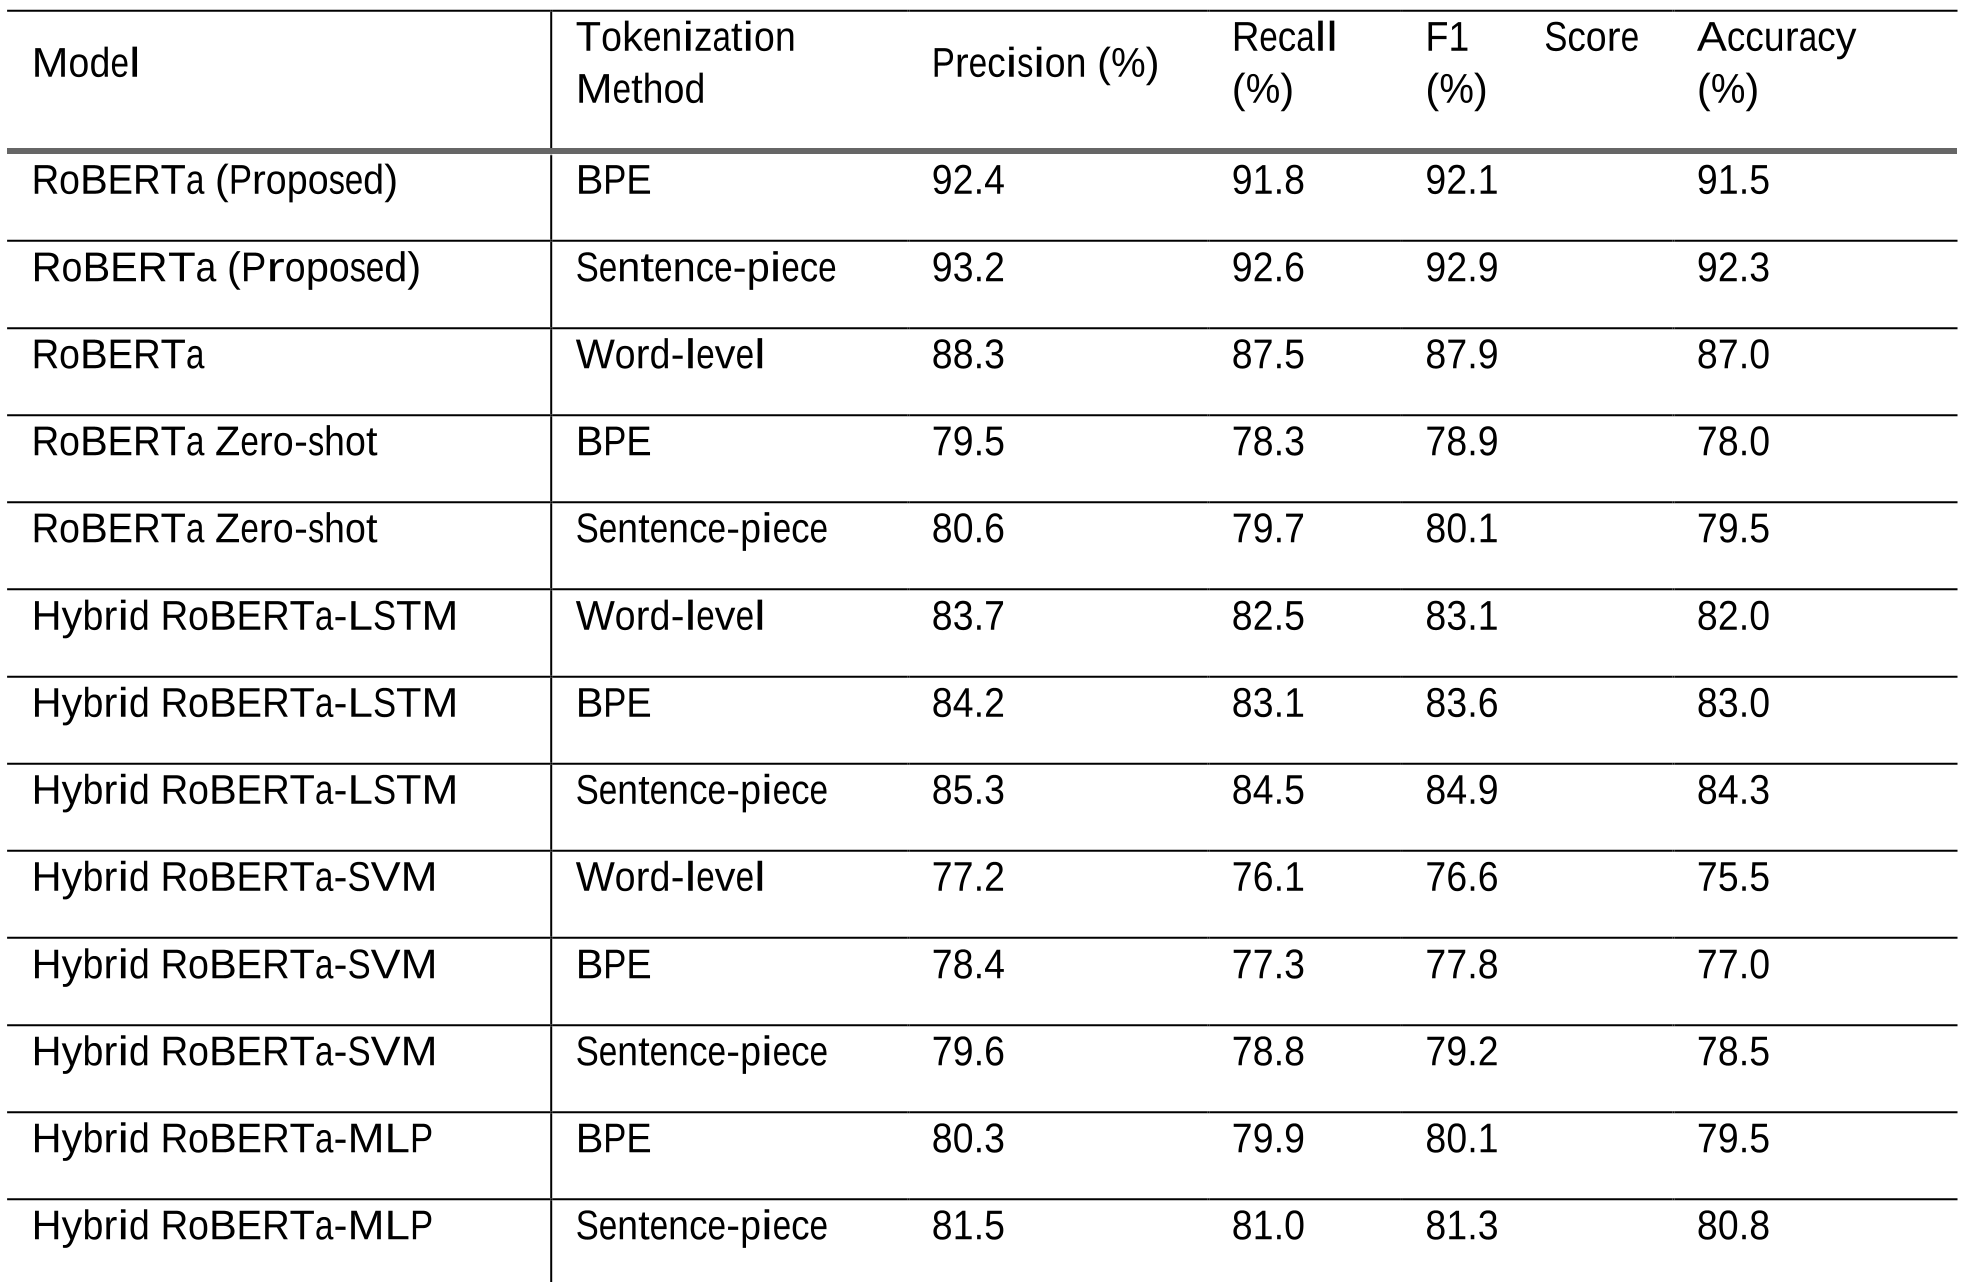
实验证明,不同的 Tokenization 方法对性能影响巨大。针对库尔德语的构词特性,Sentence-piece 显著优于传统的 Word-level。因为它能更好地处理子词(Subword)信息,解决了库尔德语中大量复合词和派生词的表征问题。
3. 实验战绩与 SOTA 对比
作者对比了多种组合模型,包括混合 LSTM、SVM 及传统的微调方式。
- 性能巅峰:提出的
NER-RoBERTa + Sentence-piece方案达到了 92.9% F1-score。 - 对比提升:
- 较 Zero-shot 提升了 12.8%(证明了任务特定微调的必要性)。
- 较 Hybrid RoBERTa-LSTM 提升了 8.0%(证明了改良 Transformer 架构比堆叠循环神经网络更有效)。
- 鲁棒性验证:在 BPE 和 Sentence-piece 两种子词分词下,模型均保持了 92% 以上的高性能,展现了极强的泛化能力。
4. 深度洞察与局限性
为什么这种方法有效?
- Inductive Bias(归纳偏置):Adapter 层通过冻结主干网络,维持了 RoBERTa 在海量文本中学习到的双向上下文理解能力。
- 形态感知:Sentence-piece 缓解了低资源语言最头疼的 OOV(Out-of-vocabulary)问题。
局限性分析: 尽管取得了突破,但该研究目前仅聚焦于 Sorani 方言。库尔德语其他方言(如 Kurmanji)之间的语法差异依然可能导致模型性能崩塌。此外,数据集规模(1500 条)虽然在特定领域够用,但在覆盖更广泛的非规范文本(如社交媒体内容)时仍显薄弱。
5. 总结
NER-RoBERTa 不仅为库尔德语 NLP 提供了新的基准,更提供了一套低资源语言适配的可行方法论:通过轻量级 Adapter 结合精确的分词策略,可以在极小规模的数据上“撬动”大模型的性能。