MathSmith: 像“铁匠”一样锻造极限难度的数学奥数题
MathSmith: Towards Extremely Hard Mathematical Reasoning by Forging Synthetic Problems with a Reinforced Policy
本文提出了 MathSmith,一个旨在通过合成极高难度题目来增强大语言模型(LLM)数学推理能力的框架。该方法不依赖现有题目模板,而是从 PlanetMath 中随机采样知识点(Concept-Explanation 对),并通过强化学习(RL)优化生成题目的结构、复杂度和答案一致性。
TL;DR
在 LLM 迈向 AGI 的道路上,数学推理是衡量“智力”的关键标尺。然而,由于人类竞赛题目数量有限,模型提升遭遇瓶颈。清华大学等机构的研究者提出了 MathSmith,它摒弃了传统的“改写模板”方式,而是从数学百科全书 PlanetMath 中抓取原始概念,通过强化学习(RL)自主“锻造”出极其复杂的数学题。实验显示,它在 AIME 等硬核竞赛测评中展现出卓越的提分效果。
痛点深挖:为什么现有的数学合成数据“不够硬”?
传统的数据合成策略(如 MetaMath, WizardMath)大多是在现有题库的基础上做微调。这种方式存在两大弊端:
- 近亲繁殖:生成的题目脱离不了原始人类题目的分布,难以产生真正意义上的“新难题”。
- 难度失控:虽然可以通过调整 Prompt 来增加难度,但模型给出的难度往往缺乏客观、物理的度量标准。
作者受“苦涩的教训”(The Bitter Lesson)启发,认为与其教会模型人类的解题技巧,不如建立一个能够自主产生高难度挑战的“环境”。
方法论详解:三阶段锻造流程
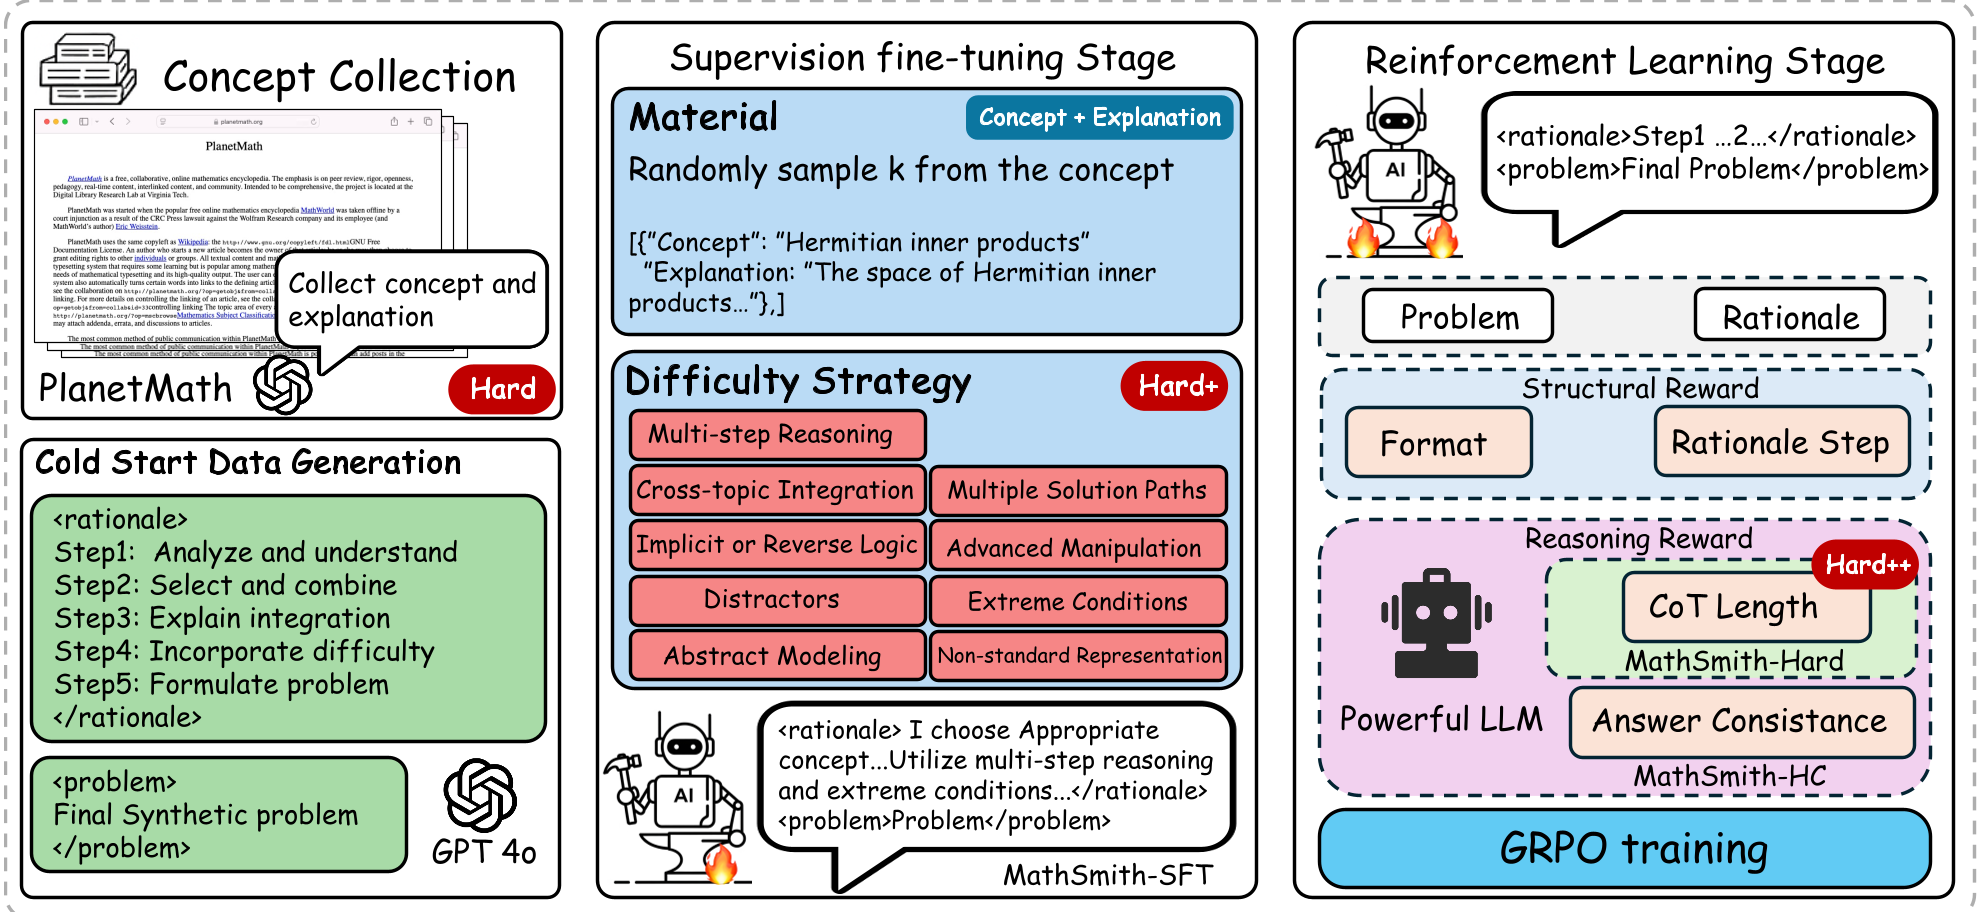
1. 概念原材料收集 (Concept Forging)
MathSmith 不从“题目”开始,而是从“概念”开始。它从 PlanetMath 中提取了 11,000 对“概念+解释”。由于这些内容涵盖了高等数学和深奥理论,为生成高难度题目提供了扎实的“物理基础”。
2. SFT 与 9 大难度策略
在冷启动阶段,作者设计了 9 种策略作为硬性约束,要求模型在生成题目时必须至少整合其中两种:
- 跨话题集成 (Cross-topic Integration):例如将数论与几何结合。
- 隐式逻辑 (Implicit Logic):隐藏关键约束条件。
- 非标准表示 (Non-standard Representation):用不常见的数学符号或描述方式。
3. 基于 GRPO 的强化学习
这是本文的核心。作者使用了 Group Relative Policy Optimization (GRPO) 算法,并设计了一个多维度的奖励函数(Reward Function):
- 结构奖励:确保生成的题目格式对、步骤对。
- 复杂度奖励:关键 Insight —— 使用教师模型在“思考模式”下产生的推理轨迹长度(Token Length)来代表题目难度。越难的题,模型想得越久、写得越长。
- 一致性奖励:确保生成的题目不是乱编的,必须有确定的答案(Majority Answer)。
实验战绩:让 LLM “想得更深”
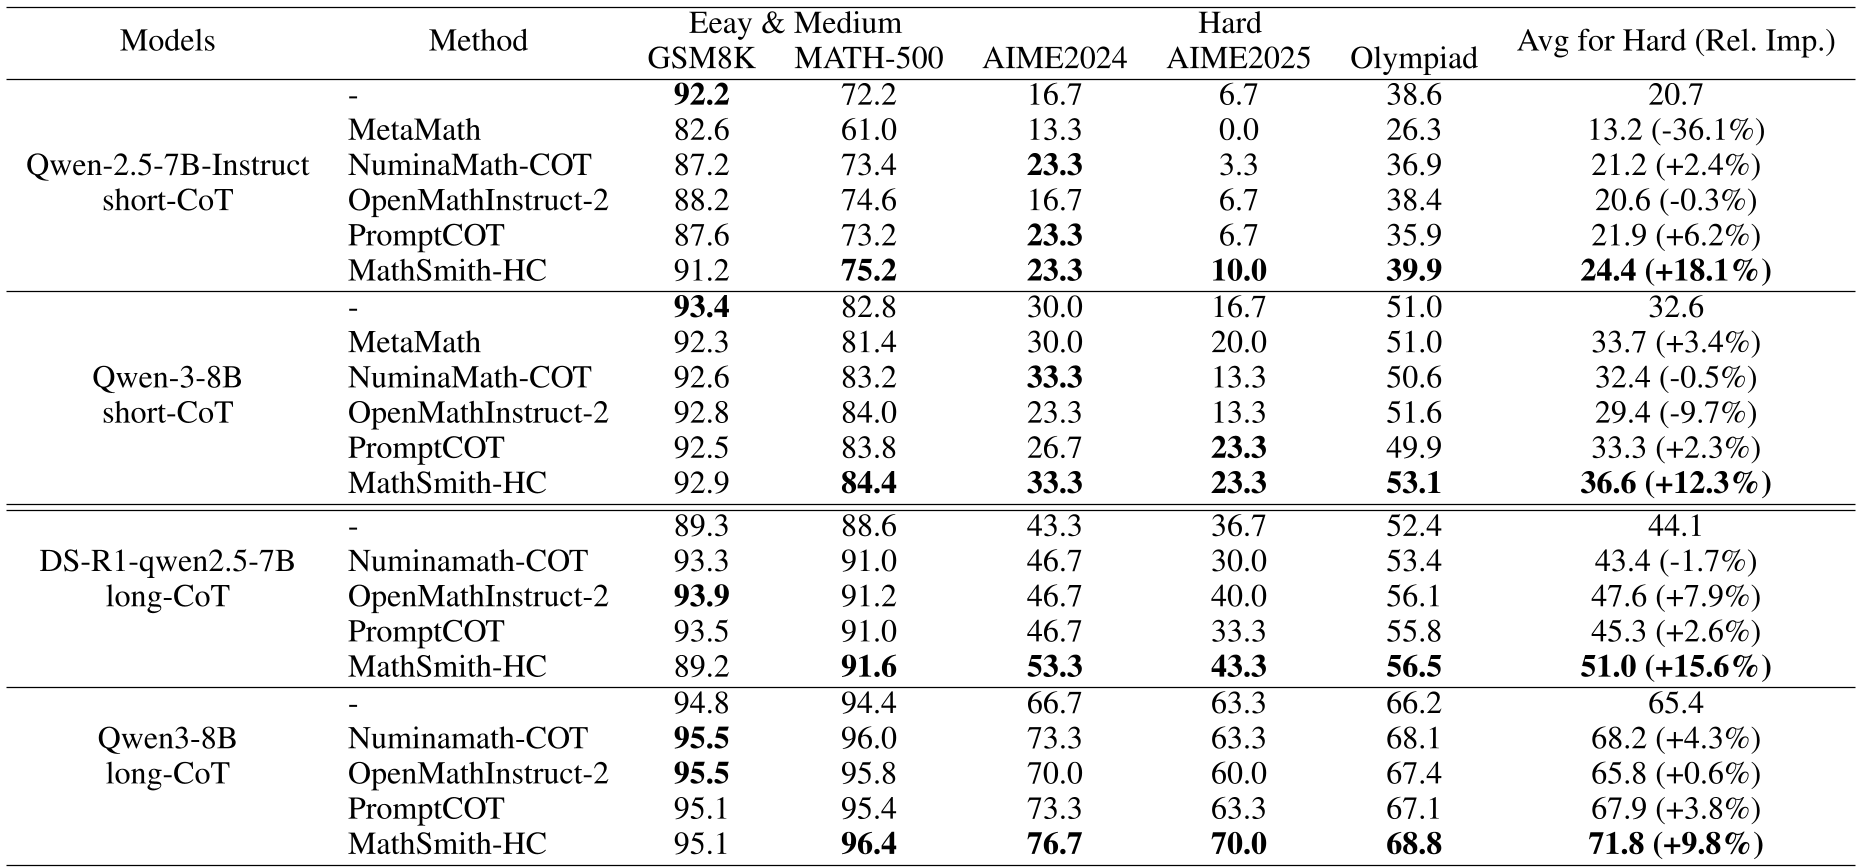
实验将基准测试分为两个梯队。在 GSM8K 等简单梯队,MathSmith 表现平稳;但在 Hard 梯队(AIME 2024/2025, OlympiadBench),MathSmith 的优势被极速放大。
核心结果分析:
- Long-CoT 表现出色:在 Qwen3-8B 模型上,使用 MathSmith 合成数据训练后,AIME 2025 的成绩提升了 9.8% 至 15.6%(相对增幅)。
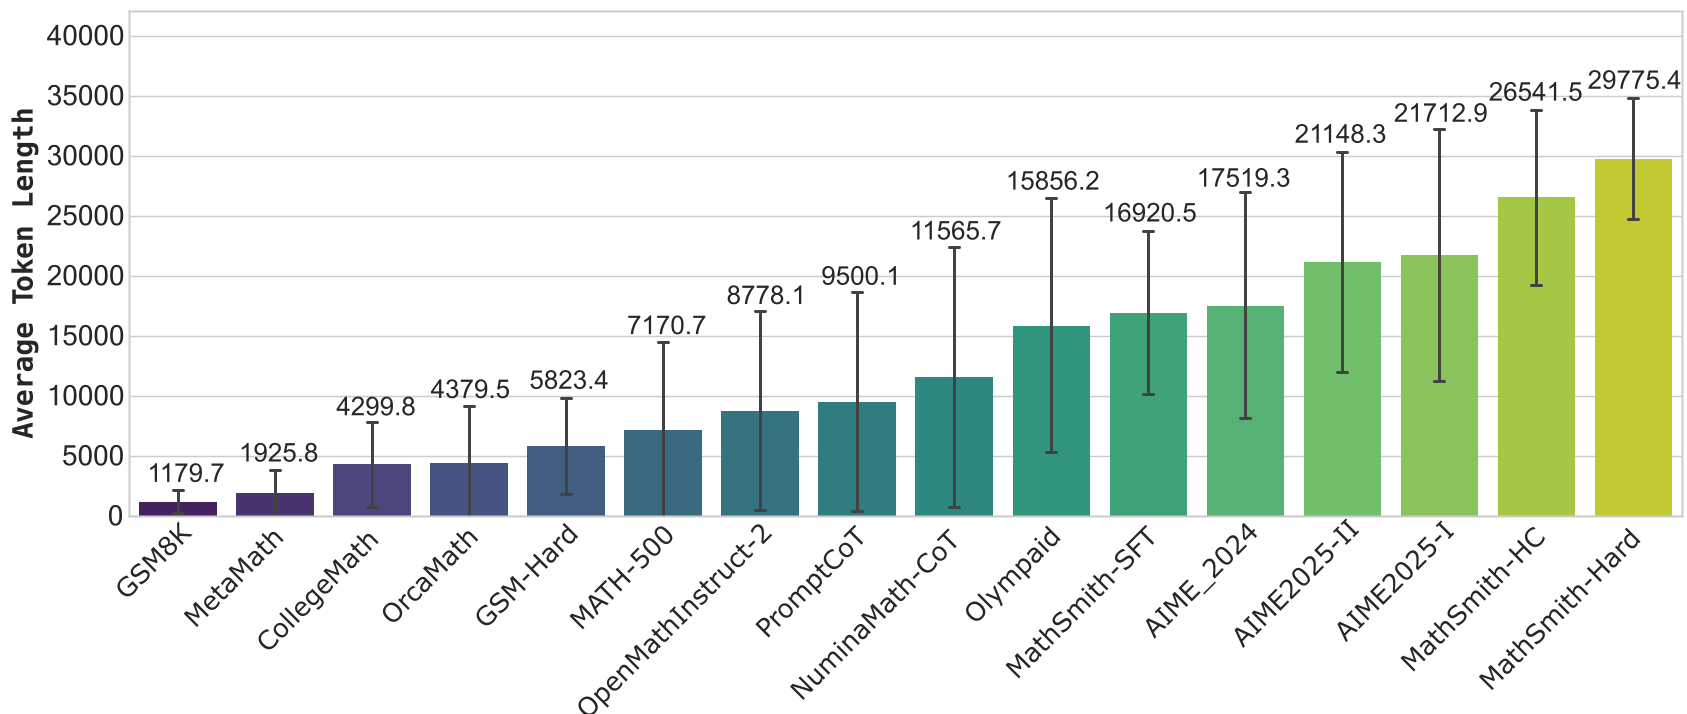
- 推理长度相关性:下图展示了 MathSmith 生成的题目(红色/橙色条柱)能诱发模型产生远长于常规数据集(如 GSM8K, MATH)的推理过程,证实了其“认知复杂度”的有效性。
深度洞察:弱点针对性训练
MathSmith 还支持一个名为 Weakness-focused 的管道。由于题目是基于概念生成的,如果模型在某类概念上表现不佳,框架可以定向大量生成该领域的“变体题”进行特训。这类似于人类备考时的“错题本/弱项针对练习”。
总结与局限
Takeaway:MathSmith 证明了即使不模仿人类题目,仅靠“硬核概念+强化学习复杂性引导”,也能锻造出高质量的合成数据,且这种数据具有极强的迁移能力。
局限性:推导轨迹长度虽然是难度的良好代理指标,但并不完美,未来可能需要更精细的方法(如验证步骤的逻辑熵)来进一步量化“难度”。