
谁是伪装之王?深度解析 LLM 文本检测的难点与模型差异
Which LLMs are Difficult to Detect? A Detailed Analysis of Potential Factors Contributing to Difficulties in LLM Text Detection
本文通过对多领域数据集的详尽实验,分析了不同大语言模型(LLM)生成文本的可检测性差异。研究采用了基于 DistilRoBERTa 的分类器,并利用 LibAUC 库优化 AUC 指标,发现 OpenAI 家族模型生成的文本在多个写作领域中均表现出极高的隐蔽性,最难被现有检测器识别。
TL;DR
并非所有 AI 生成的文字都一样容易被逮住。剑桥大学与德州农工大学的最新研究发现,OpenAI 家族(如 GPT-4)生成的文本在统计特征和复杂度上与人类高度契合,是当前最难被检测的“伪装者”。研究通过优化 AUC 指标并分析文本熵值,揭示了科学写作和创意重写任务中 AI 检测的真实困境。
背景定位:从通用检测到精准拆解
在 LLM 泛滥的今天,AI 文本检测器正陷入一场“军备竞赛”。过去我们认为 AI 说话冷冰冰、有规律,但本文指出:检测难度不仅取决于检测器本身,更取决于背后的模型家族和写作领域。 这是一个从单一基准测试向多模型、多领域细致评估转化的 SOTA 级分析工作。
痛点深挖:为什么有的 AI 文本能瞒天过海?
作者指出,现有的检测研究通常将所有 AI 文本混为一谈,但在实际应用中:
- 数据不平衡:人类文本与 AI 文本的比例往往极不平衡,导致传统分类器误报率高。
- 领域差异:科学写作(Scientific Writing)由于术语固定,AI 极易模仿,检测难度远高于新闻或评论。
- 模型进化:像 GPT-4 这种经过海量数据调优的模型,已经掌握了人类词汇分配的统计规律。
方法论详解:LibAUC 与 DualSampler
为了公平对比不同模型的检测难度,研究者采用 DistilRoBERTa 作为骨干网络,并引入了 LibAUC 库进行训练。
核心架构图
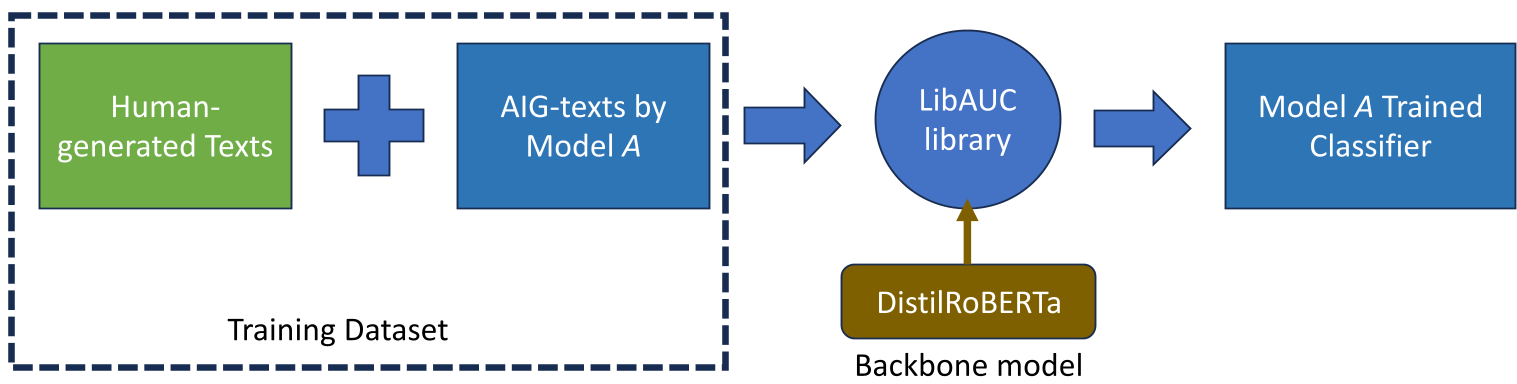 图 1:AI 文本分类器训练框架,通过更换不同的生成模型 A 来测试检测器的泛化力。
技术要点:
- CompositionalAUCLoss:直接优化曲线下面积(AUC),而非传统的交叉熵,这使得模型能够在正负样本极度不均的情况下依然保持稳健。
- DualSampler:确保每个 mini-batch 中 AI 和人类文本比例平衡,强化边界学习。
实验与结果:OpenAI 的统治力
实验涵盖了 Llama、Mistral、Claude 和 OpenAI 等多个家族。结果令人警醒:
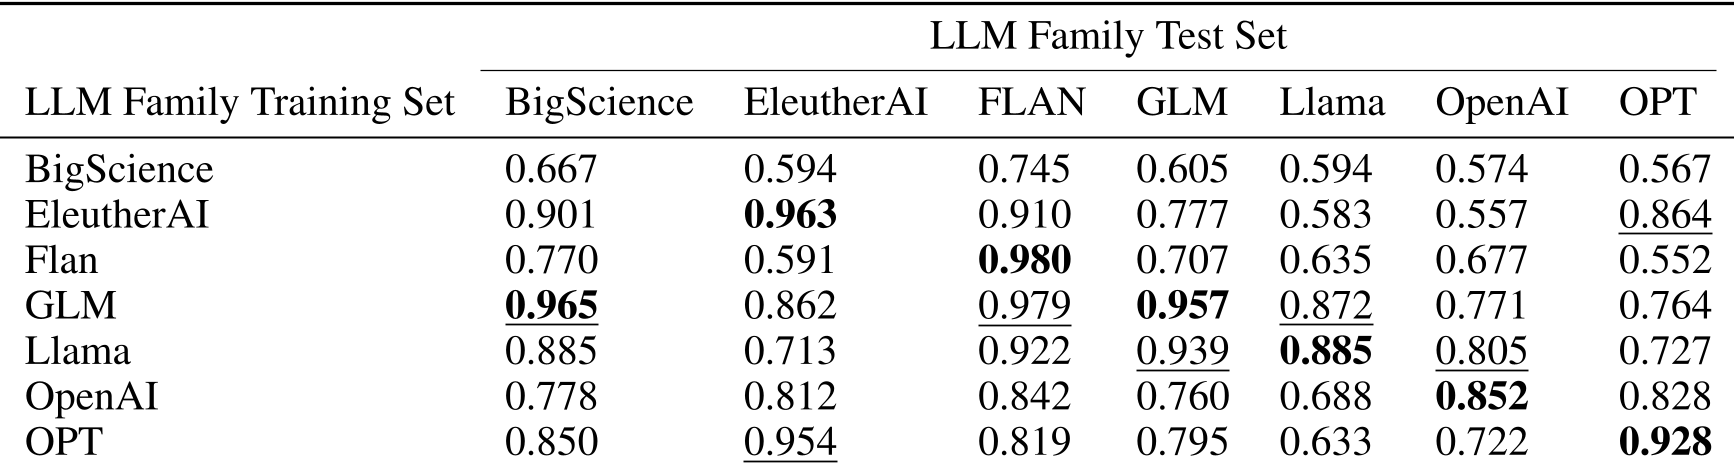 表:在 RIP 数据集上,除 OpenAI 字训练的分类器外,其他模型在检测 GPT 系统文本时 AUC 分数显著偏低。
深度洞察:统计学层面的“降维打击”
通过对文本**熵(Entropy)和词表外词汇(OOV)**的分析,研究者找到了 OpenAI 难被检测的原因:
- 高复杂度:如图 4 所示,OpenAI 文本的熵值分布曲线显著“右移”,与人类文本的分布高度重合。这意味着它不仅词汇丰富,序列预测的难度也更接近人类。
- 词汇借用:在重写任务中,OpenAI 模型能更聪明地保留人类原有的低频词(OOV),从而消除了典型的“AI 工业味”。
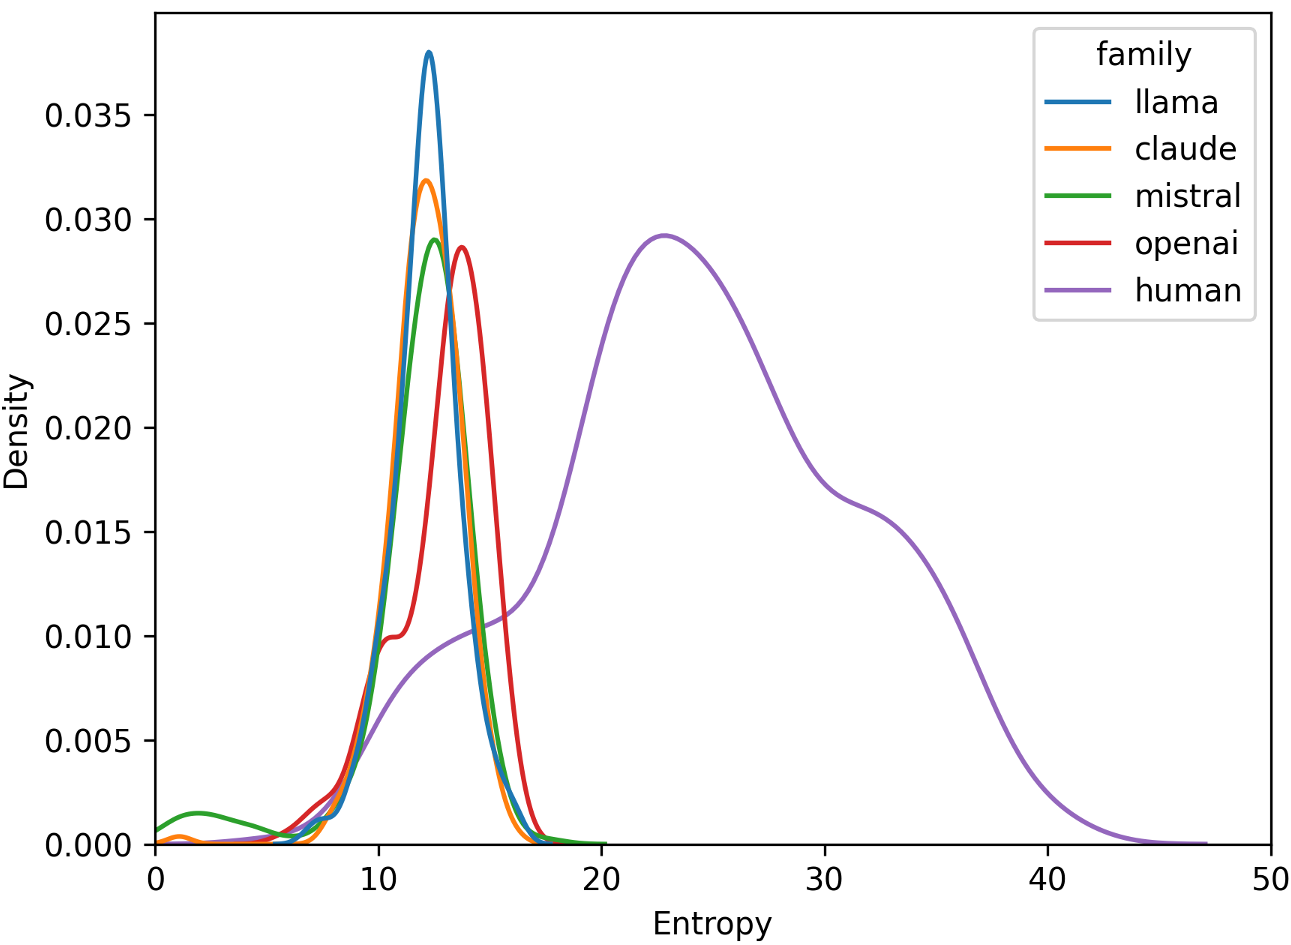 图 4:OpenAI(红色)的熵值分布最接近人类(黑色虚线),展示了极高的文本复杂度。
总结与局限性
Takeaway: 检测 AI 文本不再是“有或无”的问题,而是针对不同模型“强与弱”的较量。OpenAI 的领先不仅在于逻辑,更在于其生成的底层统计特征已逼近人类。
局限性:
- 本研究主要集中在长文本(学生论文、科学论文),对于短文本(如推文、评论)的检测依然是巨大挑战。
- 未来展望: 随着提示工程(Prompt Engineering)的进化,人为诱导 LLM 改变统计特征将成为新的对抗路径,开发者需构建更具鲁棒性的多模态/多特征检测矩阵。