
[Tech Analysis] 谁是潜伏最深的伪装者?深度解析不同 LLM 文本的可检测性
Which LLMs are Difficult to Detect? A Detailed Analysis of Potential Factors Contributing to Difficulties in LLM Text Detection
本文对不同大语言模型(LLM)生成文本的可检测性进行了深度分析。研究通过在两个大规模数据集上使用 DistilRoBERTa 模型,并利用 LibAUC 库优化 AUC 指标,系统评估了不同 LLM 家族(如 OpenAI, Llama, Claude 等)在多个写作领域中的检测难度。
TL;DR
并非所有 AI 生成的文本都一样容易被识破。最新的研究通过对 OpenAI、Llama、Mistral 等主流模型的详尽实验发现:OpenAI 家族(尤其是 GPT-4o)生成的文本最具“欺骗性”。通过改写任务,这些模型产生的文本在统计特征(如熵值和词汇多样性)上已经与人类写作达到了高度同步。
背景定位
在学术诚信、虚假新闻识别等领域,检测 AI 文本已成为刚需。然而,该论文指出,当前社区缺乏对“到底哪些模型更难抓”的细致刻画。本文是一篇实证研究性质的 SOTA 分析,它不仅提供了新的检测基准,还从语言统计学角度解释了为什么 OpenAI 能在检测器面前“隐身”。
痛点深挖:领域差异与重写攻击
传统的 AI 检测器往往在简单的生成任务上表现良好,但在以下两个场景中会遭遇滑铁卢:
- 特定领域(Domain Specificity):科学写作(Scigen)比故事创作(WP)更难检测,因为专业术语的固定性限制了 AI 表现其“机器味”的空间。
- 改写攻击(Rewritten Attack):当用户要求 LLM 模仿人类的用词习惯进行改写时,AI 的统计规律会被大幅掩盖。
方法论详解:AUC 最大化与特征分析
作者采用了 DistilRoBERTa 作为基础分类器。为了解决数据不平衡问题(人类样本通常少于 AI 样本),研究引入了 LibAUC 库。
1. 损失函数重构
不同于传统的 Cross Entropy,本文使用了 CompositionalAUCLoss:
L_AUC (w - α∇L_CE(w))
这种方法直接优化接收者操作特征曲线下的面积,确保了即使在样本极度倾斜的情况下,检测器依然能保持较低的误报率(False Positive Rate)。
2. 模型架构与训练
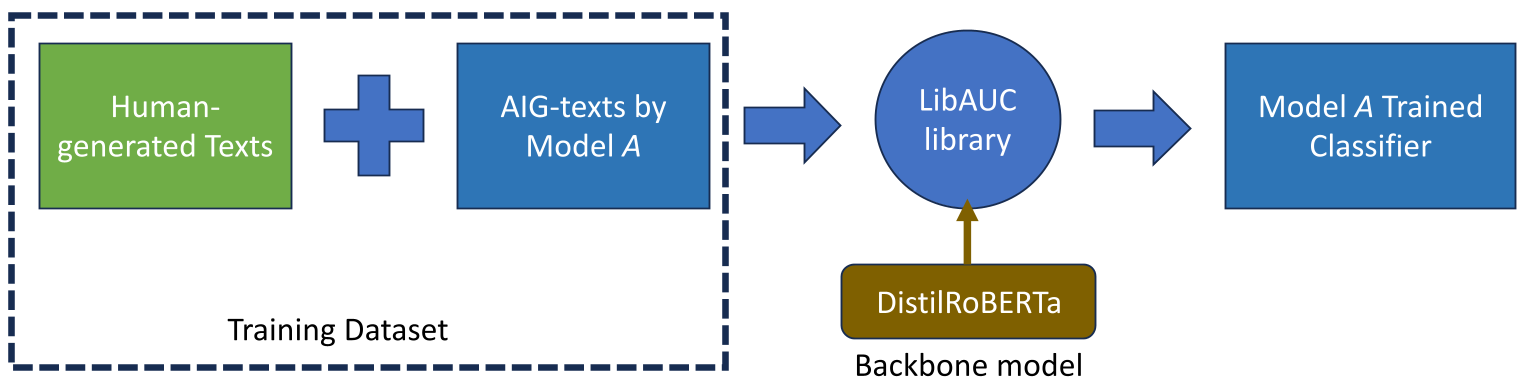 图 1:通过不同 LLM 家族训练分类器的框架图
实验与结果:OpenAI 的绝对优势
在 RIP 数据集的对比中,研究发现了一个令人不安的事实:除了用 OpenAI 自己的数据训练出的检测器,其他所有检测器在面对 GPT-3.5 或 GPT-4o 时性能都会骤降。
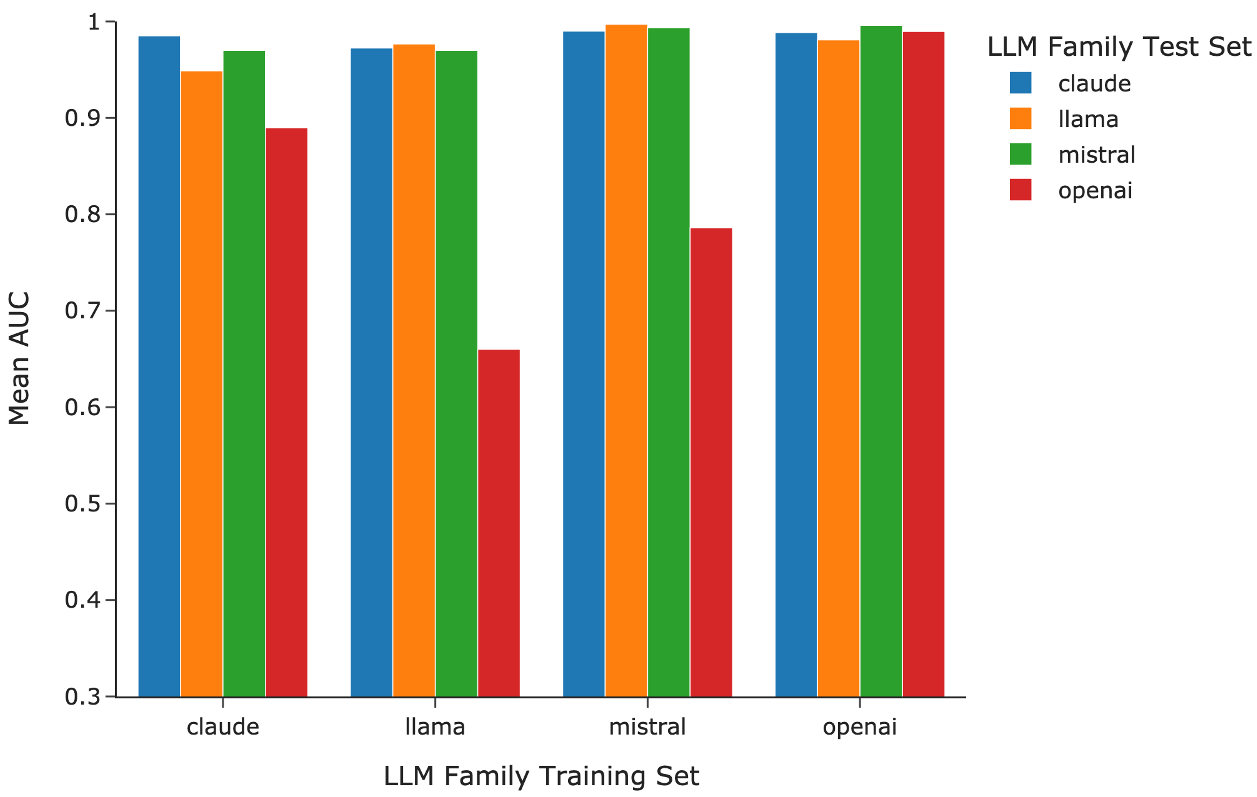 图 3:不同模型家族在测试集上的 Mean AUC 表现,OpenAI 显著领先于其他家族
深度分析:为什么 OpenAI 难以被检测?
作者通过 Shannon Entropy(香农熵) 揭示了背后的物理直觉:
- 熵值分布:人类文本的熵值通常更高(更不可预测)。如图 4 所示,OpenAI 的熵值曲线(红色)明显比 Llama 或 Mistral 更靠右,这意味着它的文本复杂度更接近人类。
- OOV(词汇表外)占比:OpenAI 能够精准“借用”人类原稿中的低频词汇,使其在词频特征上完美融入人类论文。
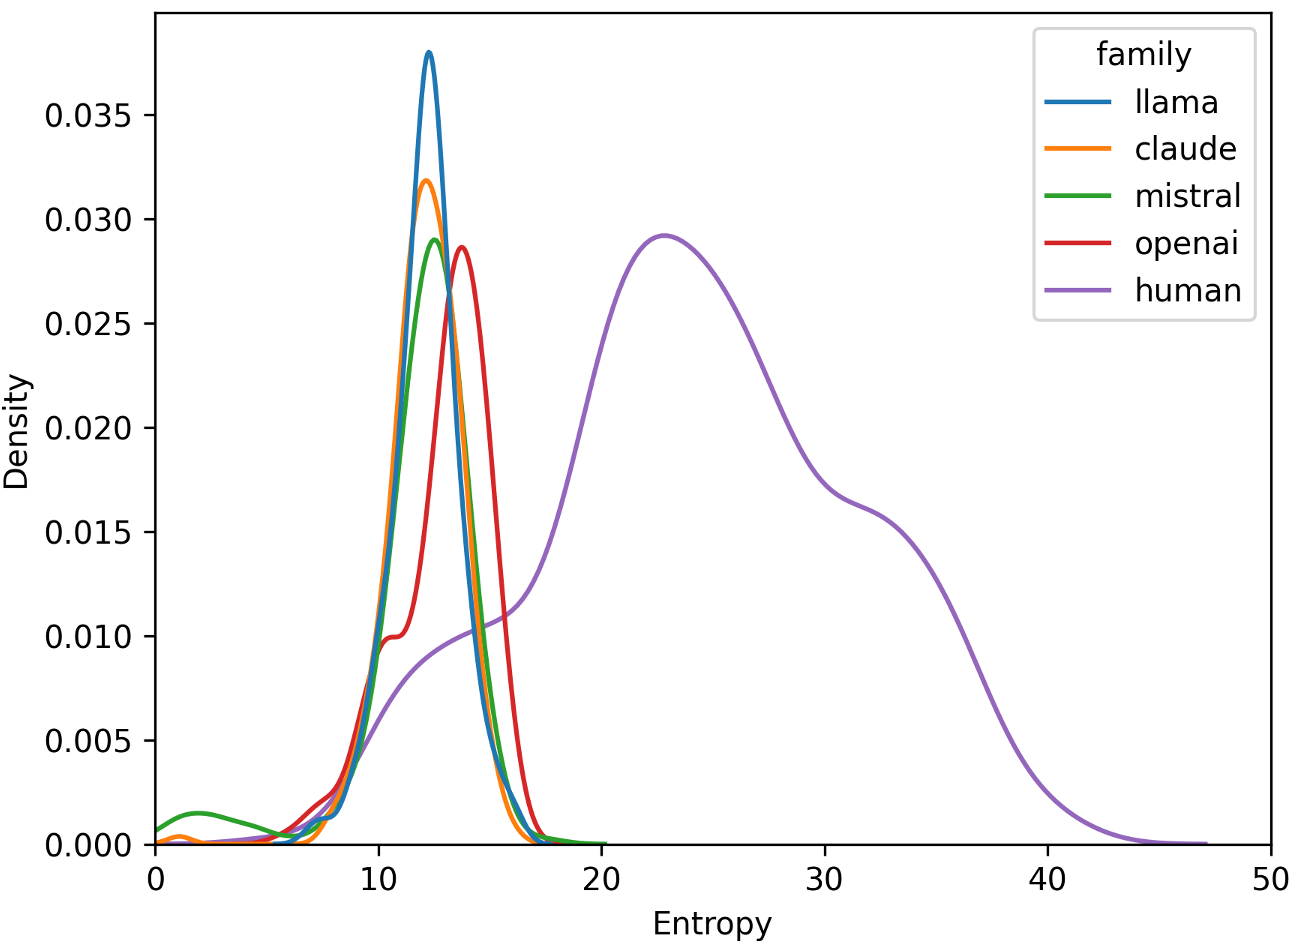 图 4:OpenAI 文本与人类文本在熵值分布上的重合度最高
深度洞察与总结
Takeaway
- 不要指望通用的检测器:在科学写作等领域,必须根据领域数据定制检测模型。
- 模型间的“代差”:目前的开源模型在模仿人类行为方面,与 OpenAI 的闭源模型仍有显著差距。
局限性与展望
本文主要研究了长文本。随着短文本(如社交媒体推文、评论)的 AI 泛滥,如何在信息量更少的情况下获取足够的统计显著性(Statistical Significance)将是下一个研究高地。未来的检测技术可能需要从简单的二分类转向基于拓扑特征或动态分布的异常检测。
结论:OpenAI 已经通过强大的预训练能力跨越了“机器味”的鸿沟,未来的检测器开发者需要更先进的特征提取手段,才能在这一场博弈中不掉队。