
LatentMAS:告别文本中介!让多智能体在隐空间实现无损、极速协同
Latent Collaboration in Multi-Agent Systems
本文提出了 LatentMAS,这是一种针对多智能体系统(MAS)的无须训练(Training-free)的端到端隐空间协作(Latent Collaboration)框架。该方法使大语言模型(LLM)智能体能够直接在连续隐空间(Continuous Latent Space)中进行自回归推理与无损通信,在 9 项数学、科学、常识和代码生成的主流基准测试中显著超越了传统的文本媒介多智能体基准,刷新了无损高效智能体协同的性能记录。
1. 核心速览 (Executive Summary)
TL;DR
在 Agentic AI 时代,多智能体系统(MAS)已成为迈向系统级智能的关键。然而,现有的多智能体系统大多将**离散文本(Text)**作为智能体之间沟通的“普通话”。这种做法不仅带来了高昂的 Token 编解码开销和漫长的推理延迟,更因离散化造成了语义的严重流失。
为了解决这一痛点,学术界顶尖团队联合提出了 LatentMAS —— 一个**无须训练(Training-free)**的端到端隐空间协同框架。LatentMAS 彻底摒弃了中间步骤的文本生成,让智能体在连续隐空间(Continuous Latent Space)中直接推进自回归推理,并通过直接传输与合并层级 KV Cache 实现了无损的隐性工作记忆传递。
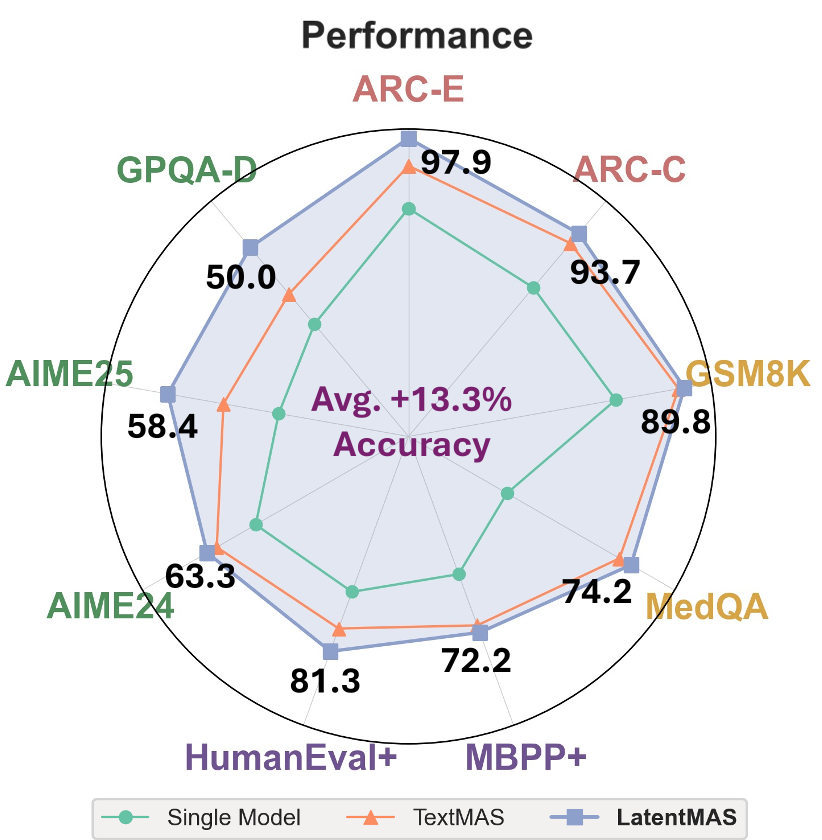 Figure 1. LatentMAS 在任务准确率、推理速度和 Token 使用量上的综合表现(横跨 9 个基准和 3 种模型尺度)。相比单模型和传统文本 MAS,LatentMAS 实现了惊人的效率与精度双重飞跃。
背景定位
传统的 MAS 是在“模型层(Model-level)”通过自然语言进行分布式交互;而 LatentMAS 成功切入了“表征层(Representation-level)”,将多智能体协作推进到纯连续隐表征空间。它在领域坐标系中不仅是效率刷榜的先锋,更在多智能体无损通信的理论基础上迈出了关键一步。
2. 痛点与动机 (Problem & Motivation)
现有 Text-based MAS 的瓶颈
- 高延迟与 Token 膨胀:在复杂的 Sequential(链式)或 Hierarchical(层级)多智能体架构中,Planner、Critic、Refiner 等角色会生成海量的中间思考文本(如 Chain-of-Thought)。这些文本不仅增加了吞吐量负担,更极大地拉长了端到端解码延迟。
- 信息忠实度流失(Discretization Loss):大模型内部的连续隐藏状态(Hidden States)蕴含着极其丰富的多维语义和不确定性。一旦将其解码(Decode)成离散的 Token,再由下一个智能体重新编码(Encode),其中很多语义细节就会丢失,这就好比“传话游戏”中的信息衰减。
- 错误累积(Error Compounding):在串行文本交互中,上游智能体生成的微小表述偏差,会被下游智能体误认为是既定事实,从而在流水线中级联放大,导致最终 Solver 彻底跑偏。
核心研究直觉(Insight)
“既然每个模型本身都是在隐表征空间进行内部计算,那么智能体之间的协作为什么不能也直接发生在隐空间中?”
基于这一直觉,作者提出了一个大胆的设想:让智能体(1)直接在最后一层隐藏状态上自回归地生成“隐式思维”(Latent Thoughts),(2)通过共享 KV Cache 无损地传递“隐性工作记忆”,实现真正的端到端隐空间协同。
3. 方法论详解 (Methodology - The Core)
LatentMAS 整体设计极其优雅,不包含任何可训练参数(Training-free),主要由三大支柱构成:自回归隐式思维生成、基于线性对齐的表征纠偏和基于 KV Cache 共享的工作记忆传递。
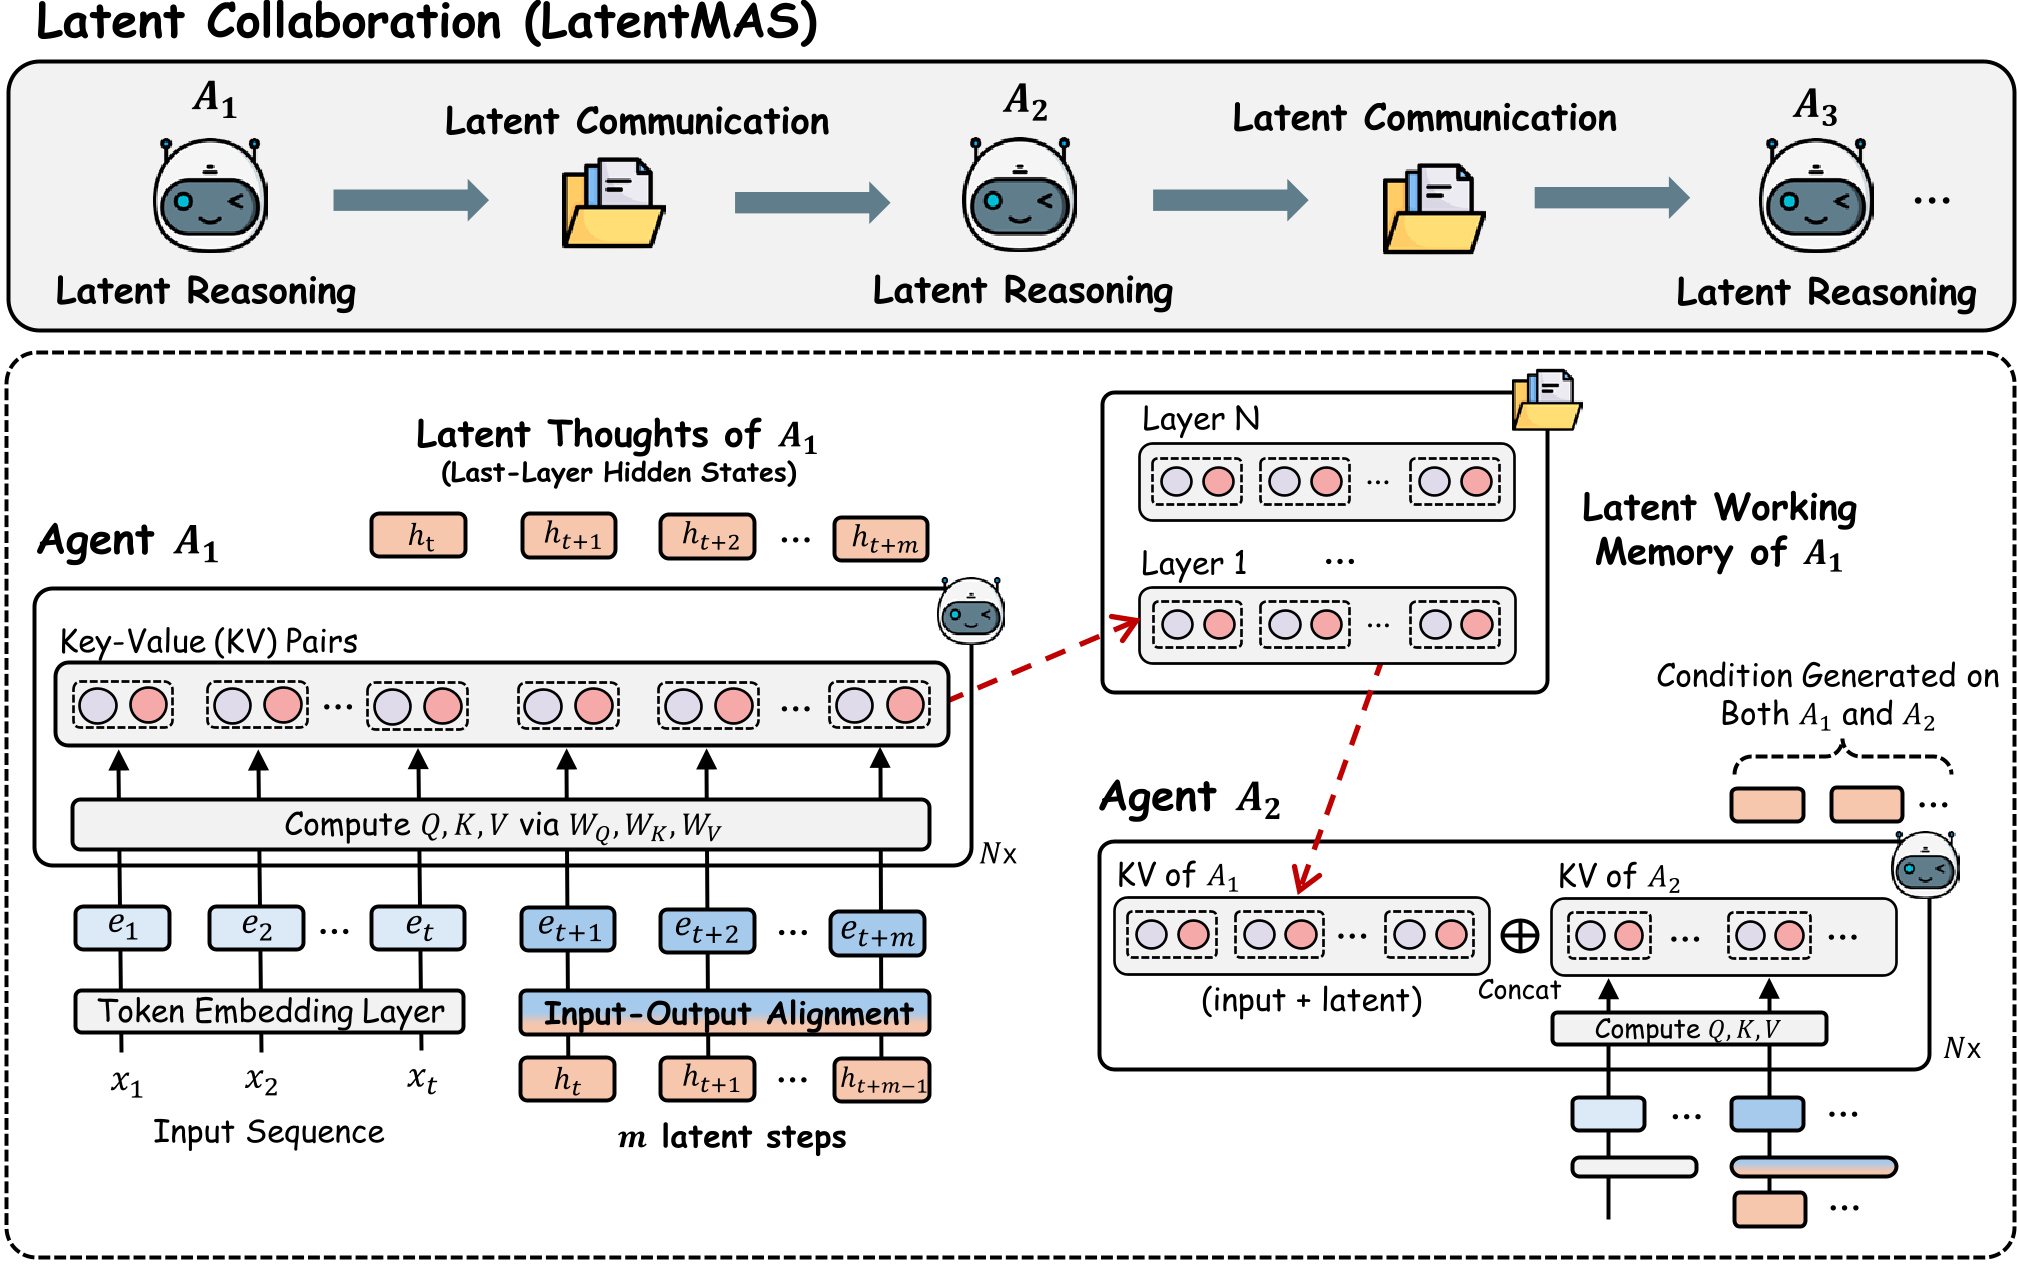 Figure 2. LatentMAS 整体架构总览。智能体首先在最后一层自回归地产生隐式思维,并通过线性对齐算子 修正几何偏差,随后将积累的层级 KV Cache(隐性工作记忆)直接无损传递给后续智能体。
3.1 自回归隐式思维生成 (Auto-regressive Latent Thoughts Generation)
在标准 Transformer 生成任务中,下一 Token 的生成概率由最后一层隐藏表征 与输出嵌入矩阵 作用后决定(式1):
而在 LatentMAS 中,智能体不执行这一解码过程,而是直接提取最后一层的隐藏层状态 ,将其直接插回并作为下一步推理的输入。经过 个隐式步骤,生成一段高维连续隐式向量序列:
3.2 线性输入-输出对齐算子 ()
直接将最后一层的隐藏状态 插回浅层(Input Embeddings)会面临致命的问题——表征偏移(Representation Drift)。因为最后一层的隐藏表征在几何结构和数理分布上与输入 Token 的 Embedding 存在巨大差异(即 OOD 问题)。
为了实现无训练的对齐,作者通过极小化对齐分布与原输入分布之间的 Wasserstein 距离(定理 A.1),推导出了一个闭式(Closed-form)线性投影算子 :
该公式是基于岭回归(Ridge Regression)的伪逆近似解, 是为了数值稳定性引入的微小超参数。该对齐算子在推理前一次性计算完成,在后续 latent 步骤中重复使用,计算开销完全可以忽略不计。
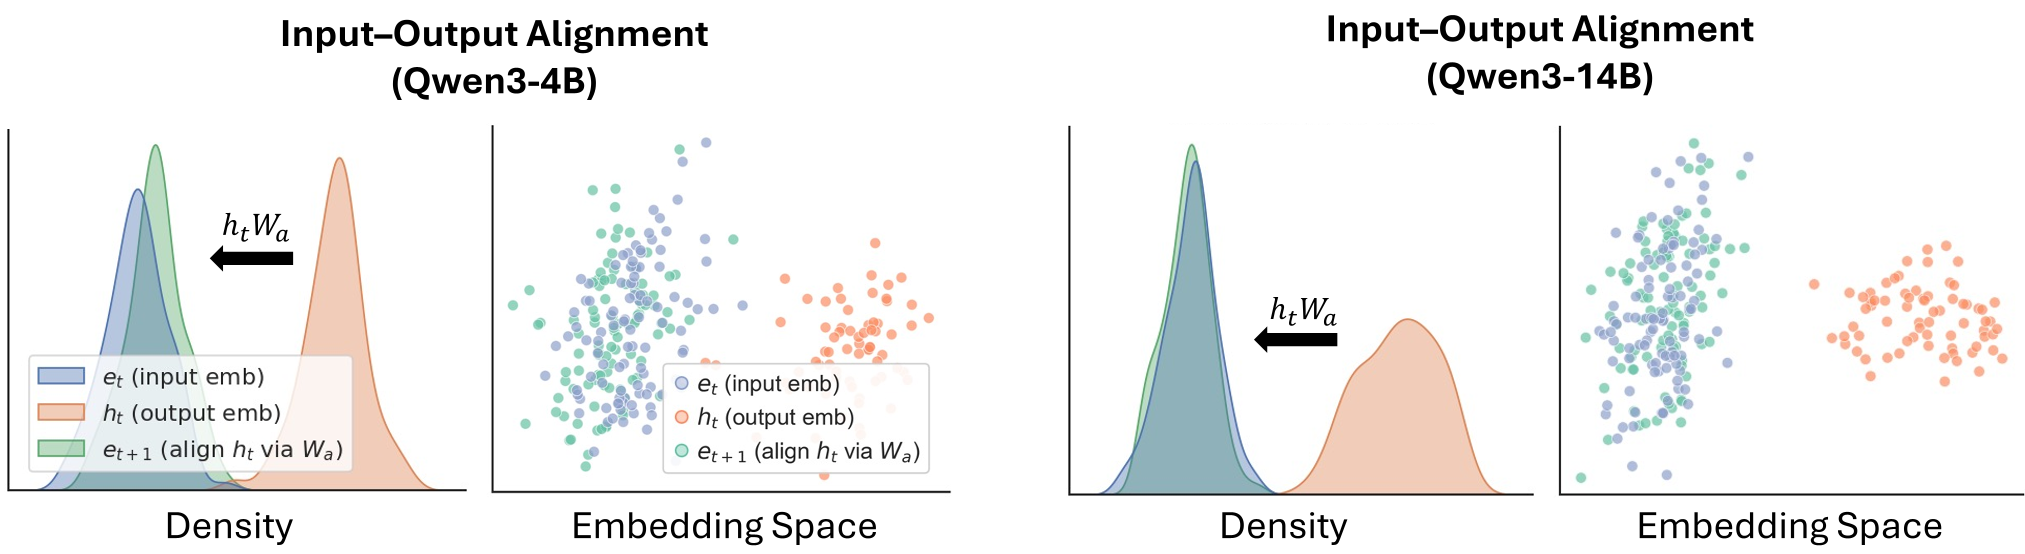 Figure 3. 线性对齐算子 的效果分析。未对齐的输出表征 明显偏离了输入分布,而经过 映射后的 完美重构了原有输入 Embedding 的几何与数理结构,有效遏制了多步推理中的表征偏移。
3.3 基于 KV Cache 的隐性工作记忆传递
在 Text-based MAS 中,下游智能体需要耗费计算资源去对上游发来的文本进行前向预填充(Prefill)。而 LatentMAS 的策略更为彻底:直接捕获上游智能体 累积的所有 Transformer 层级 KV Cache 集合作为“隐性工作记忆” :
当后续智能体 启动推理时,直接将 级联拼接到自身的 KV 缓存前。这就等同于 无损、无延迟地直接继承了 所有的上下文及中间推理痕迹,完成了物理意义上的“思维同步”。
4. 实验与结果 (Experiments & Results)
作者在 Qwen3 (4B, 8B, 14B) 和 Llama3 (3B, 8B) 两个主流大模型家族上对 LatentMAS 进行了全面的压力测试,覆盖了 Sequential( Planner-Critic-Refiner-Solver 管道)和 Hierarchical(专家分工汇总)两种经典的 MAS 架构(如图 4 所示)。
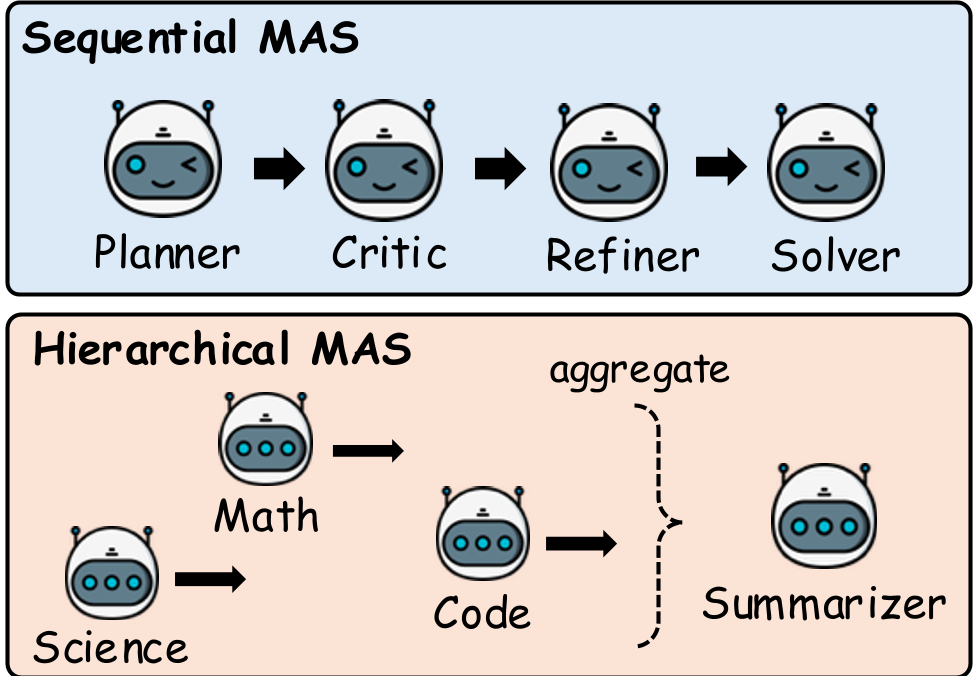 Figure 4. 实验中使用的两种经典多智能体架构:Sequential MAS(链式流水线)与 Hierarchical MAS(层级专家汇总)。
4.1 任务准确率与效率狂飙
从表 1 中我们可以窥见 LatentMAS 在 ARC 科学推理、GSM8K 数学计算、MedQA 医疗问答及 HumanEval 编程生成等综合任务中的卓越表现:
- 极致的速度提升:在 14B 尺度下,LatentMAS 将端到端推理速度提升了 3.2 到 4.5 倍。这得益于其将需要成百上千步的 Token 生成,压缩为了极少步数(如 40-80 步)的隐式推理步骤。
- 巨大的 Token 节省:系统级 Token 使用量大幅削减了 70% 到 86% 以上。
- 精度不降反升:相较于常规的文本 MAS 基线,LatentMAS 的精度最高提升了 14.6%。这强有力地佐证了连续表征在复杂多步推理中的强大语义忠实度,避免了错误累积。
4.2 隐式思维的表达多样性与对齐消融
为了探究“隐式思维”在物理空间中究竟表达了什么,作者分析了 LatentMAS 输出嵌入的几何分布:
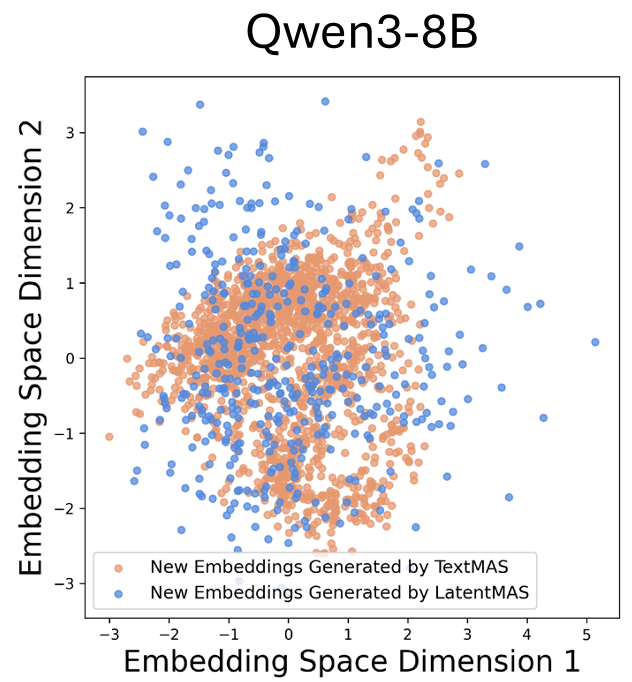 Figure 5. LatentMAS 生成的“隐式思维”嵌入(橙色区域)与 TextMAS 逐字生成的 Token 嵌入(蓝色区域)共享相同的语义空间,且隐式思维的空间覆盖度更广,蕴含着更丰富的语义特征与多维度的表达空间。
通过定量计算生成嵌入的平均成对余弦相似度(Pairwise Cosine Similarity),LatentMAS 在不同底座上均获得了比 TextMAS 更低的分数值(如 Qwen3-8B 上的 0.093 vs 0.142 ),这证明隐空间推理避免了表征坍缩,相比离散文本具备更强的信息表达容量。
5. 深度洞察与总结 (Critical Analysis & Conclusion)
5.1 核心价值
LatentMAS 打破了多智能体协作必须依赖“人类可读文本”这一传统思维定势。它证明了大模型在连续的向量世界中,可以通过 KV Cache 级联和线性投影,进行更高效、更鲁棒的协同,为构建全连续、超低延迟的“群体智能(Collective Intelligence)”确立了极具学术与工程潜力的先河。
5.2 局限性与挑战 (Limitations)
虽然 LatentMAS 开辟了极具吸引力的新范式,但其局限性也同样显著:
- 异构模型协作难(Heterogeneity Barrier):LatentMAS 目前假设协作的所有智能体拥有完全一致的 Transformer 架构和隐藏维度(如都是 Qwen3-14B )。若要在不兼容的异构模型(如 Llama3 与 Qwen 混合)之间进行隐空间协作,依然需要引入额外的可训练对齐映射层(Adapter)。
- 调试可解释性差:隐空间的表征对于人类研发人员是不可读的。尽管作者在文中设计了专门的“Debug 模式”(平行生成文本探测),但相比于纯文本 MAS,它在开发过程中的溯源和行为监控依然要复杂得多。
5.3 未来展望 (Future Work)
随着大模型端侧部署与 Agent 局域网协同技术的普及,隐表征交互终将成为超越文本中介的必然选择。未来的研究方向将集中在通过先进的多模型对齐技术打通异构多智能体的连续空间,同时利用 Post-training 强化学习在隐空间中自适应优化各智能体的合作协议,释放更深层次的协同推理潜力。