
图像生成器:被低估的视觉全能学习者
Image Generators are Generalist Vision Learners
本文提出了 Vision Banana,一个通过对预训练图像生成模型 Nano Banana Pro 进行轻量级指令微调(Instruction-tuning)构建的全能视觉模型。该模型在 2D 语义分割、指代分割及 3D 深度/法向估计等多项任务中达到了 SOTA 水平,证明了图像生成预训练可以作为通用的视觉学习范式。
TL;DR
在自然语言处理领域,LLM 证明了“生成即理解”。而在计算机视觉领域,Vision Banana 的出现标志着类似的范式转移:通过对强大的图像生成器 Nano Banana Pro 进行轻量级的指令微调(Instruction-tuning),它在不需要特定架构设计的情况下,竟然在分割、深度和法向估计等任务上击败了 SAM 3 和 Depth Anything 等“领域专家”。
核心洞察:感知即生成
传统的视觉理解往往被视为一种“压缩”或“分类”过程,而本文作者提出了一个大胆的假设:能够创造出真实视觉内容的模型,必然已经内化了视觉世界的底层结构和物理规律。
通过将感知任务(如深度图、分割掩码)转化为特定的 RGB 颜色编码,研究者将复杂的视觉理解问题简化为一致的图像生成任务。这种方法的本质优势在于:
- 统一接口:不再需要为每个任务设计 Head(如分割头或深度回归头)。
- 知识迁移:生成模型在海量数据预训练中获得的“世界常识”(例如物体的大小比例、光影遮挡)可以直接服务于几何推理。
方法论:轻量级指令微调 (Instruction-tuning)
Vision Banana 并没有进行全参数的大规模重练,而是借鉴了 NLP 中的指令微调。它在原始生成数据的混合物中加入少量视觉任务数据,比例极低,从而确保模型“不忘初心”(保留生成能力)。
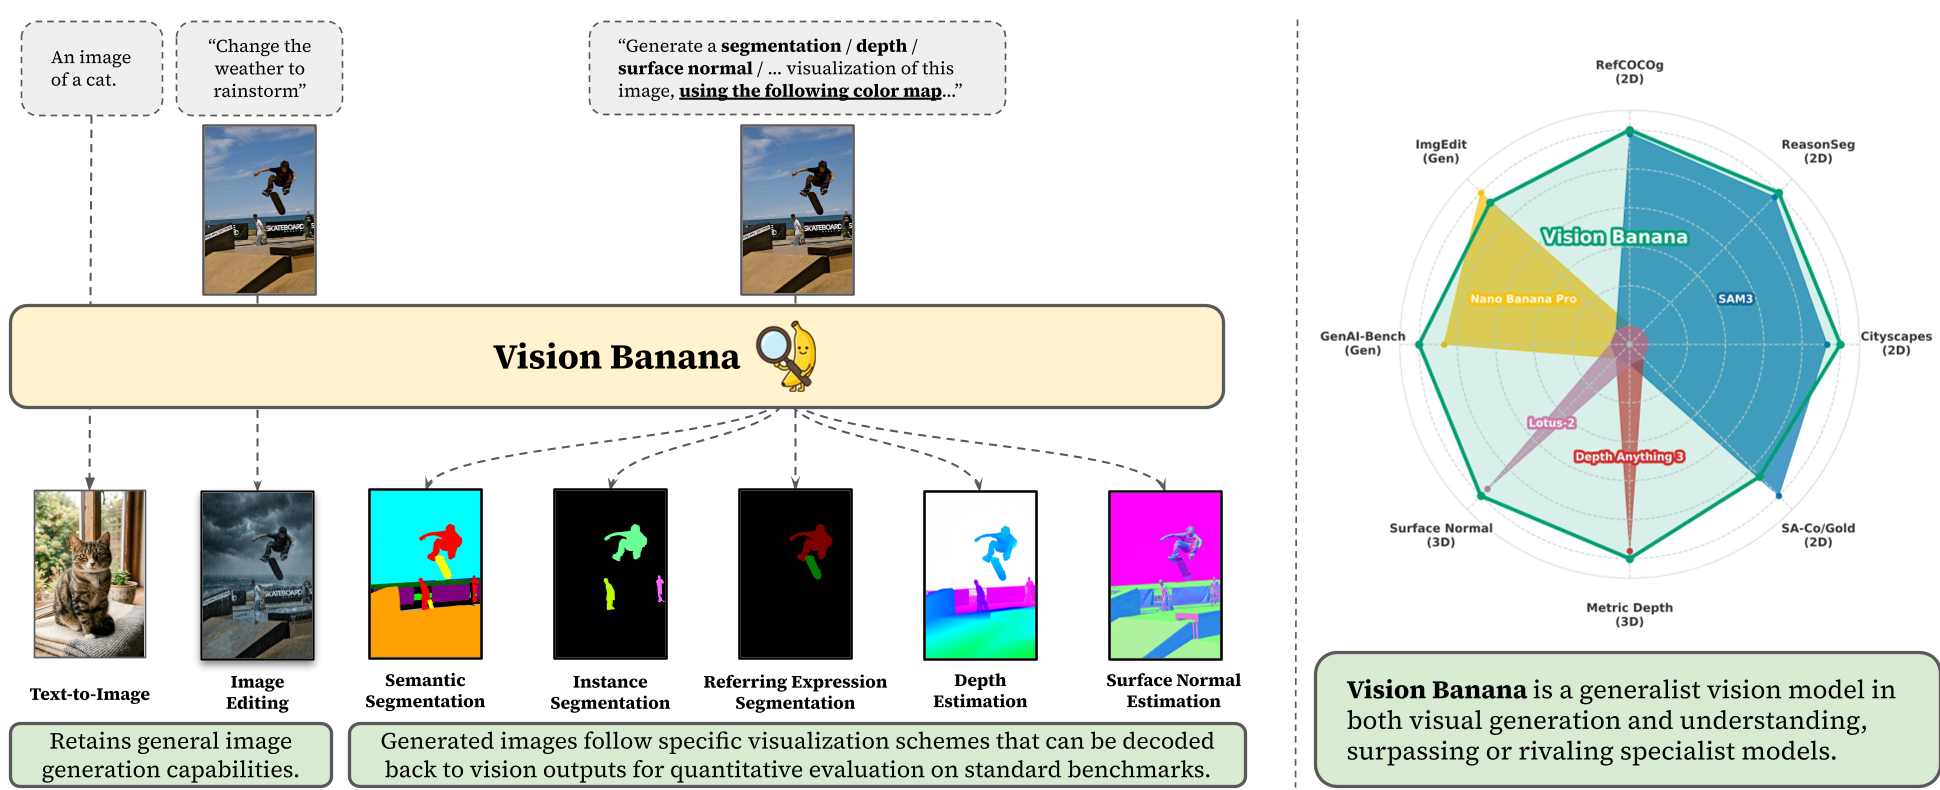 图 1:通过指令驱动,生成器输出可解码为物理参数的 RGB 图像
几何推理的“黑科技”:度量深度估计
最令人惊叹的是其在 3D 理解上的表现。作者通过一种可逆的幂变换(Power Transform)和 RGB 立方体映射,将 [0, ∞) 的度量深度映射到 RGB 空间。
这种设计不仅解决了深度值范围无界的问题,还利用了生成模型在处理颜色分布时的模式寻优(Mode-seeking)特性,有效避免了回归模型常见的“均值模糊”问题。
实验战绩:反杀领域专家 (Specialists)
在多项关键指标上,Vision Banana 展示了其作为“全能选手”的恐怖实力:
- 2D 分割:在 Cityscapes 语义分割任务中,其 mIoU 达到了 0.699,显著超过了 SAM 3 的 0.652。
- 3D 深度:在没有相机内参(Camera Intrinsics)辅助的情况下,它依然在多个数据集上刷新了记录。
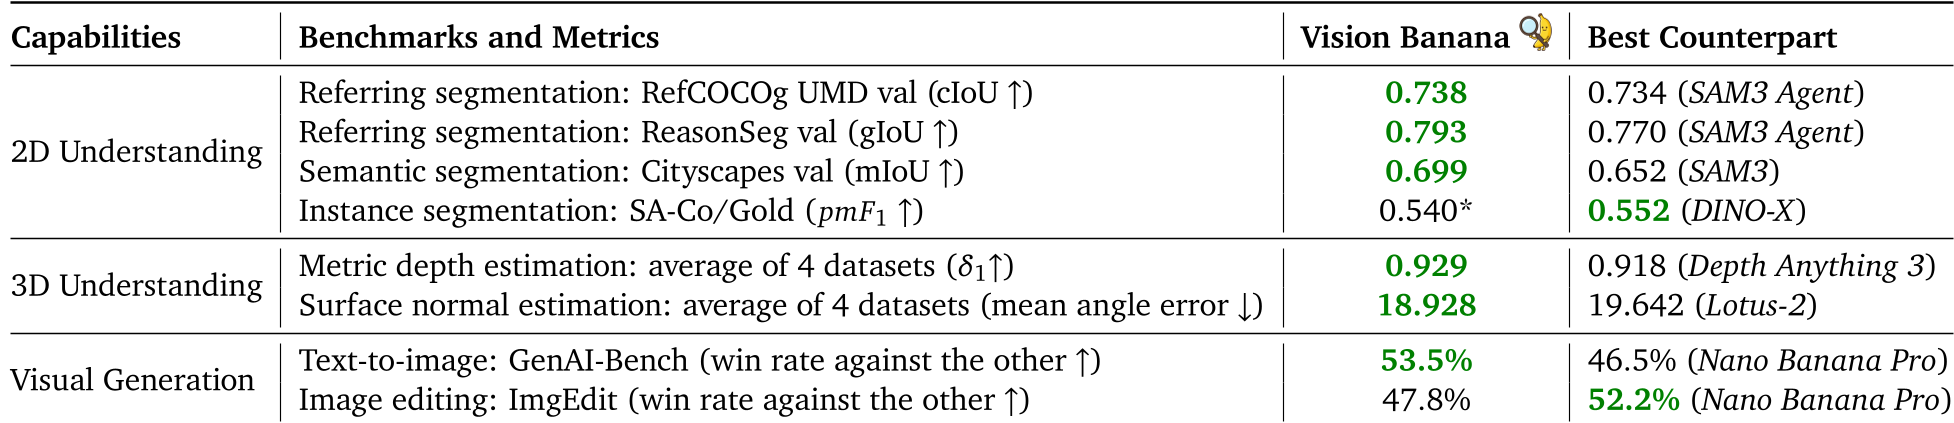 表 1:Vision Banana 与各类专项 SOTA 模型的综合对比
深度思考:视觉 AGI 的催化剂
Vision Banana 的成功揭示了视觉研究的一个新方向:Foundational Vision Models (FVM)。
- Inductive Bias 的退场:过去我们需要精心设计归纳偏置(如 U-Net, Transformers)来处理特定任务,而现在,强大的生成预训练可能已经覆盖了绝大部分必要的偏置。
- 通用接口的力量:RGB 图像作为通用接口,意味着未来的视觉模型可以像 GPT 处理文字一样,通过简单的 Prompt 切换任务。
局限性与挑战
尽管表现卓越,Vision Banana 也非完美无缺。其核心挑战在于推理成本:运行一个庞大的生成式 Foundation Model 远比运行一个轻量级的深度估计网络(如 Depth Anything)耗费更多算力。此外,如何将这种能力扩展到动态视频帧的实时理解,仍是未来的重要课题。
总结
Vision Banana 证明了:图像生成器不仅是画师,更是深刻理解现实世界的观察者。我们正在见证计算机视觉从“判别式学习”向“生成式预训练”的重大范式转移。