
FutureSim:当 AI 代理开始预知未来,我们如何衡量它们的进化?
FutureSim: Replaying World Events to Evaluate Adaptive Agents
本文推出了 FutureSim,这是一个旨在评估 AI Agent 在动态环境中长程适应能力(Long-horizon Adaptation)的模拟平台。通过逐日重放 2026 年初的全球真实新闻事件,要求 Agent 对其知识截止日期之后的事件进行持续预测,顶尖模型 GPT 5.5 在该基准上达到了 25% 的 Top-1 准确率。
TL;DR
在 AI 领域,衡量一个 Agent 是否“聪明”的标准正在从“能写代码”转向“能随环境演进而进化”。本文通过重放 2026 年 1 月至 3 月的全球真实新闻流,构建了一个名为 FutureSim 的动态模拟平台。它要求 AI 像职业预言家一样,在不断滚动的消息中修正自己的预测。结果显示:即使是当前的顶尖模型,在长程预测和自我修正方面依然显得“笨拙”。
背景定位
目前大部分 LLM 评估就像是给学生发一套静态试卷,学生只要背诵过往知识就能拿高分。但 FutureSim 是在考“时事分析”:它将时钟拨回 2026 年初,利用 Agent 训练数据截断后的真实事件,测试 Agent 能否在长达 90 天的模拟周期内,通过每天接收的新闻动态调整判断。这是从静态 Benchmark 向 长程测试时适应 (Long-horizon Test-time Adaptation) 的一次范式转移。
痛点深挖:为什么 LLMs 难以预测未来?
- 锚定效应 (Anchoring Effect):实验发现,一旦 Agent 做出了初始预测,即使后续证据证明其错误,它们也倾向于坚持原见。
- 搜索效率低下:传统的 RAG 往往只是一次性的。但在动态环境中,Agent 需要“有目的地”随着时间推移去搜索缺失的关键碎片。
- 校准度极差:许多模型往往会给出极其自信的错误答案。
核心方法论:FutureSim 的运作机制
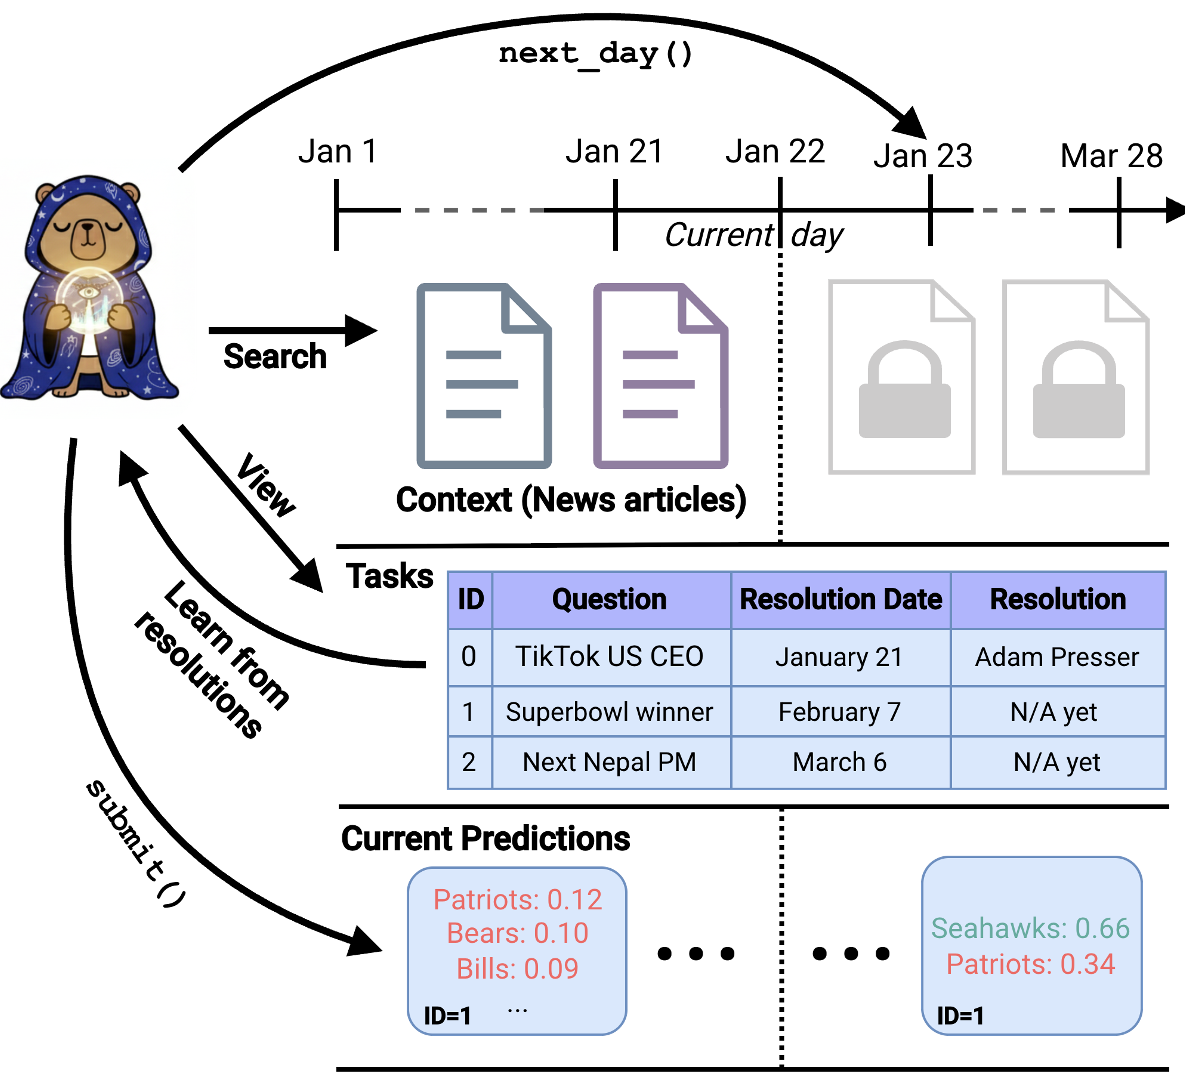
FutureSim 不仅仅是一堆新闻列表,由于采用了 Sandboxing (沙盒) 技术,Agent 无法穿越回未来获取答案,只能访问到当前模拟日期之前的“历史新闻”。
1. 架构与交互
Agent 拥有两个核心动作:
submit_forecast(): 提交或更新对某一事件的概率分布预测(包括最多5个可能的结果)。next_day(): 推进时间轴,接收新的一天的语料库。
2. Brier Skill Score (BSS) 的精妙应用
作者没有采用简单的“对或错”作为指标,而是引入了数学上严谨的 Brier Skill Score。
- 公式直觉:如果你对正确答案的把握只有 10%,而给错误答案分配了 90%,你会得到负分;如果你选择“弃权”(分配 0 概率),得分是 0。
- 价值:它迫使模型学会表达不确定性(Calibrated Uncertainty)。
实验与结果:Frontier Models 的“滑铁卢”
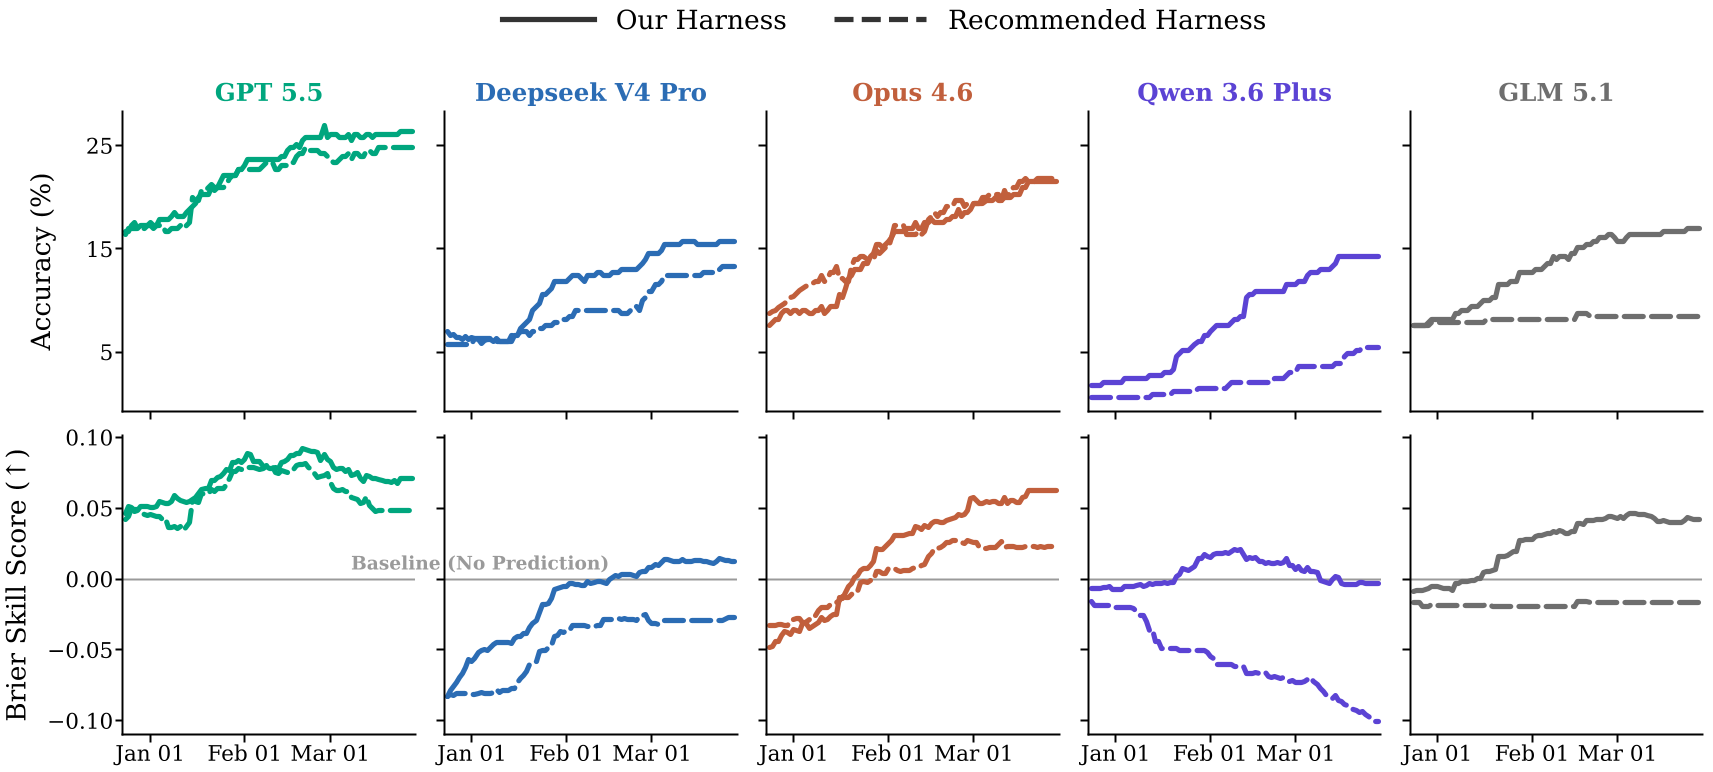
作者评估了 GPT 5.5, DeepSeek V4 Pro, Qwen 3.6 Plus 等一系列顶尖模型。
1. 性能断层
GPT 5.5 在 Codex 环境下表现一骑绝尘,准确率达到了 25% 左右。相比之下,许多开源模型在默认状态下的 BSS 得分为负,这意味着它们的预测由于过度自信,效果竟然不如直接弃权。
2. 记忆与搜索的威力
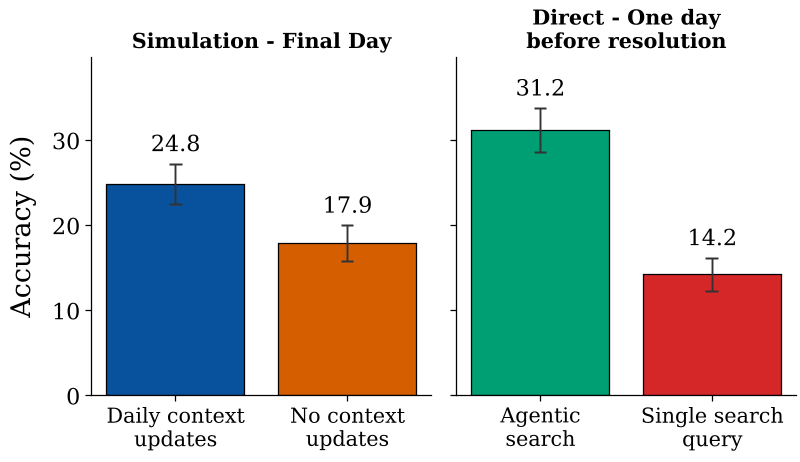
- Memory (记忆):禁用文件系统记忆后,模型的表现垂直下滑,说明 Agent 需要长期存储过去的推理逻辑以对抗“上下文漂移”。
- Inference Scaling (算力扩展):增加推理时的 Token 消耗量能有效提升准确性,尤其是在协助模型进行贝叶斯更新时(如下图所示)。
深度洞察:我们离真正的 AGI 还有多远?
观察 1:自适应能力的缺失 即使给模型提供了“你的预测目前得分是负数”的反馈,它们也难以修正其内在的逻辑。这种对初始偏见的执念(Self-conditioning)是构建自进化系统的最大障碍。
观察 2:对赌人类市场 有趣的是,GPT 5.5 在某些市场(如 Super Bowl 预测)甚至领先于人类赌博平台 Polymarket 的实时数据。这暗示了 AI Agent 在金融、安全等需要快速处理海量时序信息的领域具有巨大的潜在商业价值。
总结
FutureSim 的出现为 Agent 社区敲响了警钟:模型在静态任务上的高分或许只是对训练数据的“镜像映射”。真正的智能应该是在海量新信息涌入时,能够不断否定昨日之我,在未知中对风险和机遇进行精准定价的能力。
局限性与展望
目前平台仍处于预测性(Predictive)环境,Agent 的行为无法改变环境(就像你看球赛预测输赢,但你上不了场)。未来的研究可能会扩展到决策性(Decision-making)任务,即 Agent 的操作能够回流并改变模拟世界的走向。