
[COLING 2025] EssayDetect:学术 integrity 守护者,融合文体统计与深度学习的跨语言 AI 检测
EssayDetect at GenAI Detection Task 2: Guardians of Academic Integrity: Multilingual Detection of AI-Generated Essays
本文提出了 EssayDetect 方案,旨在解决 COLING 2025 DAIGenC Workshop 中的学术论文 AI 生成检测任务。核心方法是通过融合预训练语言模型(PLM)嵌入与 32 种语言统计(Stylometric)及语言学特征,辅以 LIME 解释性特征选择、分层冻结微调和 Focal Loss,实现了高效的英阿双语检测,在英文任务中达到 0.978 的 F1 分数。
TL;DR
随着大语言模型(LLMs)在学术界的普及,判别论文是否由 AI 生成已成为维护教育公平的刚需。来自印度理工学院(IIT)的研究团队在 COLING 2025 DAIGenC 车间提出的 EssayDetect 方案,通过将 DeBERTa/AraBERT 的深度语义嵌入与 LIME 筛选后的文体统计特征进行注意力融合,有效解决了长文本检测中的偏好偏差与类别不平衡问题。
背景定位
该工作属于 有监督的 AI 文本检测(Supervised AI Detection)。在评估基准(Subtask A & B)中,它由于引入了显式的语言学特征(Stylometric Features),打破了纯预训练语言模型(PLM)在区分学术性 AI 文本时的性能瓶颈,是典型的“特征工程回馈深度学习”的成功案例。
痛点与动机:为什么 PLM 也会被“欺骗”?
在学术论文场景下,AI 生成的内容(如 ChatGPT)通常逻辑通顺且词汇高级,这使得它在隐向量空间中与高质量的人类写作极其接近。
作者观察到三个核心痛点:
- 检测器偏见:单纯微调 PLM 容易在数据量大的类别(如人写文本)上产生过拟合,对 AI 文本的召回率低。
- 局部依赖缺失:PLM 擅长上下文理解,但对特定文体指标(如平均句长稳定性、标点分布频率)的敏感度不及传统的统计模型。
- 误报率高:将人类作者的学术表达误判为 AI,对学术声誉具有毁灭性影响。
方法论详解:融合模型架构
EssayDetect 并非简单的模型堆叠,其内部逻辑分为三层:
1. 深度文体分析(Stylometry layer)
提取涵盖三维度的特征集:
- 短语研究 (Phraseology):词数、标点分布、各段落句数等。
- 词汇多样性 (Lexical Diversity):诸如 Type-Token Ratio (TTR)、Flesch 易读度指数、Gunning Fog 指数等。
- 句法特征 (Syntactic Diversity):词性占比(POS Proportions)、情感极性与主观度。
2. 特征筛选与注意力增强
系统使用 LIME 工具筛选出对判别贡献最大的 11-12 个特征。为了不让这些特征在拼接时被高维的 PLM Embedding 淹没,引入了 Self-Attention 机制 为统计向量进行加权处理。
3. 分层微调(Layer-wise Freezing)
模型并不对整个 PLM(如 DeBERTa)进行剧烈微调,而是冻结低层:
- 低层(Frozen):保留通用的语言表征(General linguistic representation)。
- 高层(Fine-tuned):捕获特定任务(如学术论文)的文体风格偏离。
 图 1:EssayDetect 融合模型总体架构:左侧为统计特征注意力支路,右侧为 PLM CLS 嵌入支路。
实验与结果:统计特征的神奇魔力
在实验设置中,对比试验揭示了一个惊人的结论:仅依靠文本嵌入训练,性能大幅落后。
| 模型配置 | 语言 | 特征融合 | F1 Score |
|---|---|---|---|
| DeBERTa-base | 英文 | 否 | 0.617 |
| DeBERTa-base | 英文 | 是 | 0.978 |
| AraBERT v02 | 阿拉伯语 | 否 | 0.9214 |
| AraBERT v02 | 阿拉伯语 | 是 | 0.9429 |
数据的巨大提升证明了:AI 虽然能模仿人类的语气,但在“语法习惯”和“词汇密度趋势”上仍保留着及其稳定的机器特征,这些特征通过显式计算(如 Flesch-Kincaid 评分)能够被模型轻易识破。
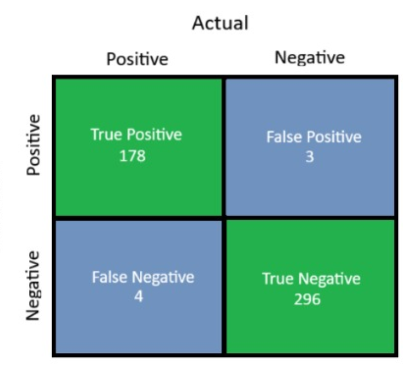 图 2:混淆矩阵显示,模型在英阿双语上均表现稳健,但阿语(右侧)的交叉误判率略高于英语,这与阿语复杂的形态学相关。
深度洞察与总结
模型亮点
- 跨语言普适性:该方法在印欧语系(英语)和闪含语系(阿拉伯语)下均有效,核心在于统计指标(如 TTR)具有一定的跨语言稳定性。
- 鲁棒性处理:Focal Loss 的引入有效解决了学术数据中常见的类不平衡问题,强制模型关注那些“写得最像人”的 AI 文本。
局限性与展望
尽管该方法取得了 97% 以上的 F1 值,但面临两个挑战:一是对抗性攻击(如用户使用特定的 Prompt 要求 AI 改变句式结构或降低易读度),二是模型的可解释性仍停留在特征层面,尚未深入到神经元如何处理文体偏离。
结论:EssayDetect 告诉我们,在对抗生成式 AI 的战场上,最先进的深度网络依然需要回望经典的“文字统计学”,这种“新老结合”的思路是目前保障学术诚信最高效的路径。