突破预训练瓶颈:Token Superposition Training 实现 2.5 倍加速
Efficient Pre-Training with Token Superposition
本文提出了 Token-Superposition Training (TST),一种无需修改模型架构或优化器的即插即用型大语言模型预训练加速方法。该方法通过在预训练初期将多个连续 Token 叠加(Superposition)为单个 latent 向量并使用 Multi-hot Cross-Entropy (MCE) 损失进行训练,在保持推理配置不变的前提下,实现了训练吞吐量的大幅提升。
TL;DR
在 LLM 军备竞赛中,算力就是硬通货。Nous Research 团队最新发表的论文提出了一种名为 Token-Superposition Training (TST) 的新范式。它不需要你改动一行模型架构代码,也不需要调整 Tokenizer,仅通过在训练初期“打包” Token 并进行多标签预测,就能在 10B 规模模型上实现 2.5 倍的加速。最重要的是,这种提升在推理时是“免费”的,模型结构保持原汁原味。
痛点深挖:Token 吞吐量的隐形枷锁
目前的 LLM 预训练大多遵循标准的下文 Token 预测(Next-token Prediction)。这种模式虽然简单,但在处理海量数据时,计算量(FLOPs)与处理的 Token 数是线性绑定的。
以往优化效率的思路通常有三:
- 信息最大化:如更好的分词算法。
- 计算稀疏化:如 Mixture-of-Experts (MoE)。
- 压缩建模:如在模型内部减少 Token 流转。
然而,这些方法要么需要复杂的架构调整,要么会改变推理时的行为。TST 另辟蹊径:如果我们在训练时让模型一次看 个 Token,并一次预测 个 Token,但保持每一步的计算开销不变,效率会发生什么变化?
核心机制:Token 的“量子叠加态”训练
TST 的运作流程非常优雅,分为两个阶段:
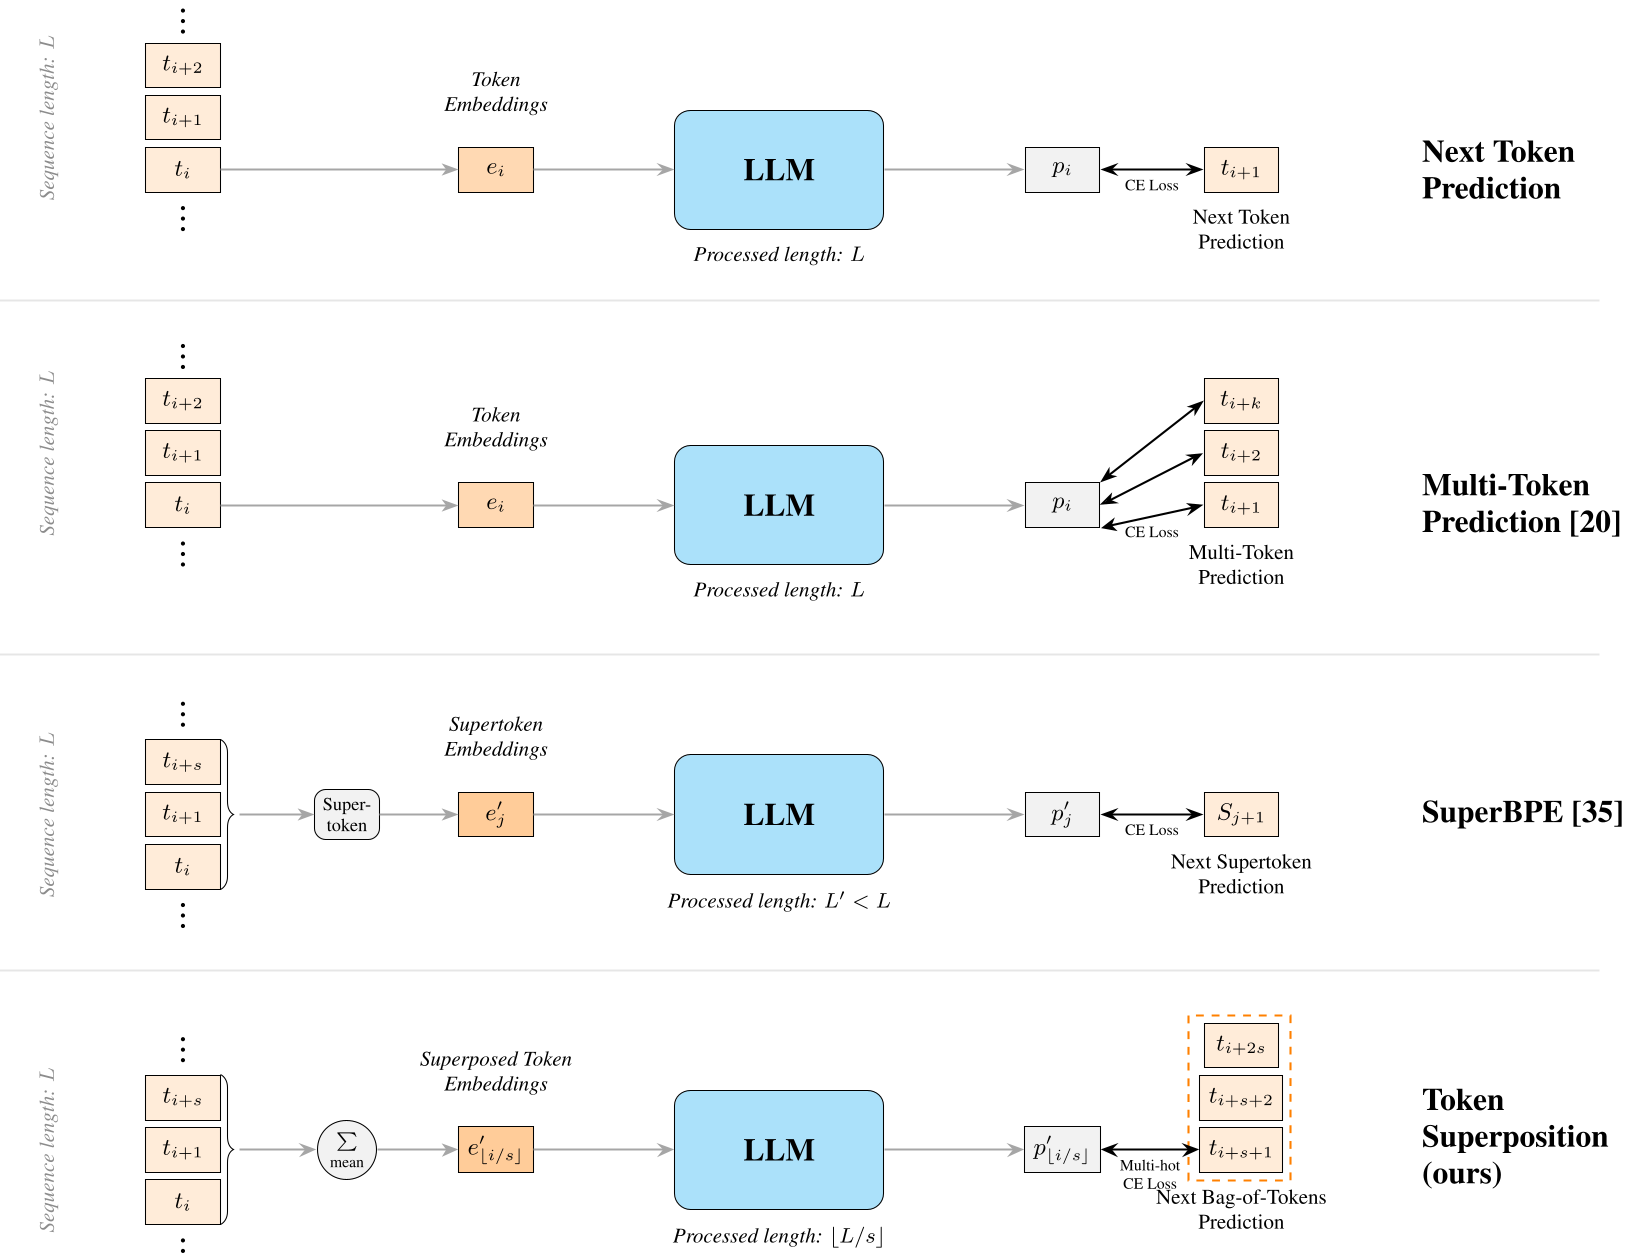
1. 叠加阶段 (Superposition Phase)
在这个阶段,模型不再一个接一个地吃 Token:
- 输入端:将 个连续 Token 的 Embedding 取平均。这意味着对于模型来说,序列长度缩短到了 ,但为了保持等量 FLOPs,作者按比例增加了 Batch 内的原始数据量。
- 输出端:模型通过一个线性头预测下一组 Token 的“口袋”(Bag)。这里引入了 Multi-hot Cross-Entropy (MCE) 损失。
2. 恢复阶段 (Recovery Phase)
当模型学习到了文本的粗粒度统计分布后,将其切换回标准的单 Token 预测。由于 Embedding 层和 LM Head 在第一阶段得到了充分的预热和对齐,模型能以极快的速度恢复并超越传统的训练曲线。
实验战绩:MoE 模型的飞跃
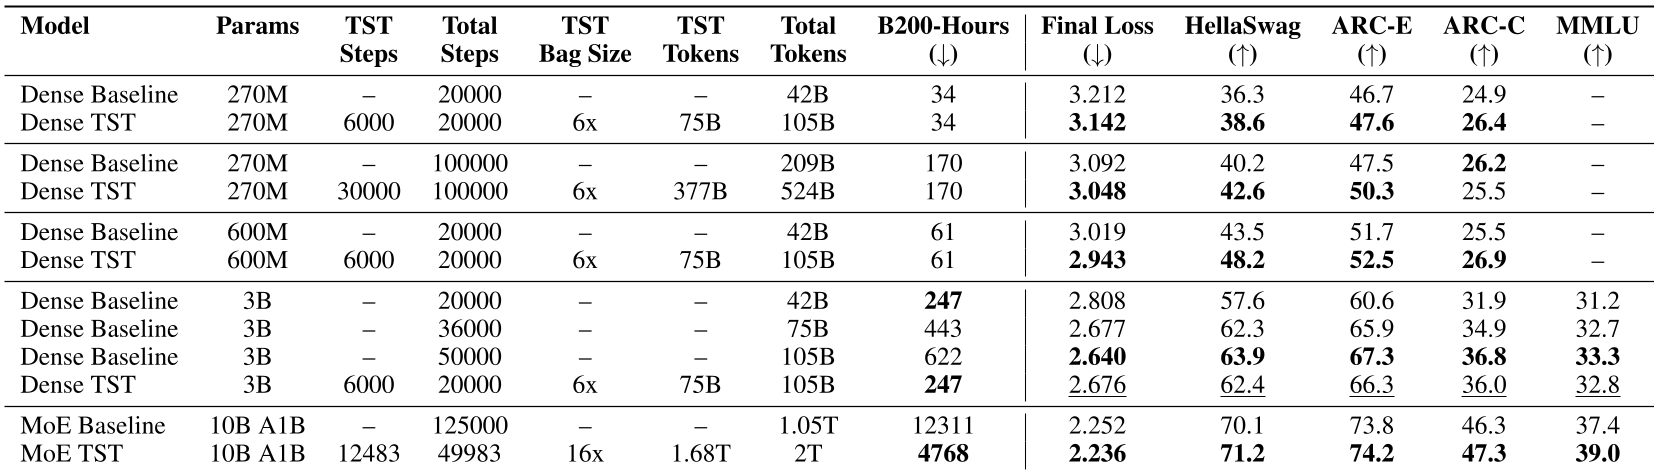
作者在不同规模(270M, 600M, 3B, 10B)上进行了详尽测试。在 10B 规模的 MoE 模型(Qwen3 架构)上,TST 展现了恐怖的效率提升。
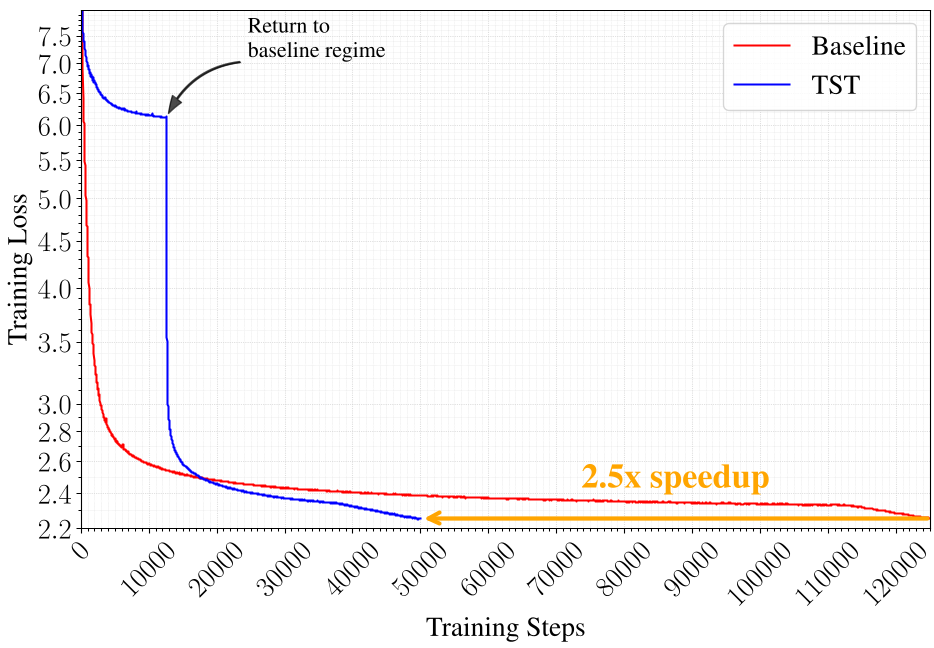
- 等 Loss 性能:TST 仅需约 40% 的计算时间(12,311 降至 4,768 B200 小时)即可达到基准模型的最终 Loss。
- 下游任务:在 HellaSwag (+1.1%)、MMLU (+1.6%) 等 0-shot 评测中,TST 训练出的模型全面占优。
深度洞察:为什么 TST 有效?
1. 表示对齐是关键
很多尝试改变训练目标的研究都失败了,因为它们在第二阶段切换时会产生巨大的“表示鸿沟”。TST 坚持在叠加阶段使用未经过任何投影层的原始 Embedding 和 LM Head。作者通过消融实验证明,一旦在恢复阶段随机初始化 Embedding,TST 的所有增益都会归零。
2. 双重机制的协同
TST 不仅仅是数据加速,它通过:
- 输入叠加:改变了输入的感知粒度,起到了一种 Inductive Bias(归纳偏置)的正则化作用。
- 输出叠加:强制模型学习未来词包的统计分布,这类似于 Multi-token Prediction,但开销更低。
总结与局限
TST 为我们提供了一个极具性价比的预训练加速方案。它告诉我们,训练时的输入粒度不一定要和推理时完全一致。
局限性:
- 数据绑架:TST 本质上是用更多的数据换取更少的计算时间。如果你的数据集非常稀缺(Data-bound),TST 的优势将大打折扣。
- 超参数敏感:叠加窗口大小 和切换比例 需要精细调优(文中推荐 , )。
对于任何正在进行大模型预训练的团队来说,TST 都是一个值得尝试的“低风险、高回报”的优化选项。