
DeTeCtive:通过多级对比学习重塑 AI 文本检测的泛化边界
DeTeCtive: Detecting AI-generated Text via Multi-Level Contrastive Learning
本文提出了 DeTeCtive,一个通用的 AI 生成文本检测框架。该框架引入了多级对比学习(Multi-level Contrastive Learning)和多任务辅助学习,通过区分作者写作风格而非简单的二分类任务,在多个基准数据集上达到了 SOTA 性能。
TL;DR
字节跳动与国科大的研究团队推出了 DeTeCtive 框架。它跳出了传统“人写 vs 机写”的二分类陷阱,转向通过多级对比学习 (Multi-level Contrastive Learning) 来捕捉文本背后的“作者笔迹”(写作风格)。该方法不仅在常规任务中刷新了 SOTA,更在面对从未见过的 LLM 或新领域数据时,展现出了极强的泛化能力和“零样本”适配潜力。
背景定位:二分类的死胡同
目前的检测器(如基于 RoBERTa 或 T5 的分类器)大多在特定数据集上“闭门造车”。一旦遇到新发布的模型(如 GPT-4o)或新的应用领域,它们的准确率会迅速崩塌。这是由于这些模型学习的是数据分布的统计过拟合,而不是真正理解 AI 写作风格的本质特征。
作者提出了一个深刻的直觉:每一个 LLM 都可以被视为一个独立的“作者”。就像人类作者有其独特的笔触,由于架构、训练数据和偏置的差异,不同 LLM 生成的文本在特征空间中应当呈现出簇状分布,且具有层级结构(例如,Llama 系列模型之间的风格亲缘关系必然高于 Llama 与 GPT 之间)。
核心方法:多级对比学习与亲缘关系建模
DeTeCtive 的核心在于其精心设计的多级对比损失函数。它不再只是把“机写文本”推向一边,而是对 AI 内部的亲缘关系进行了建模。
1. 亲缘关系约束 (Kinship Relations)
模型通过调整特征空间中的距离,确保满足以下拓扑关系:
- 同一具体模型生成的文本距离最近。
- 同一公司/家族模型(如 GPT 家族)次之。
- 所有 AI 生成文本在宏观上向一侧靠拢。
- AI 文本与人类文本保持最大距离。
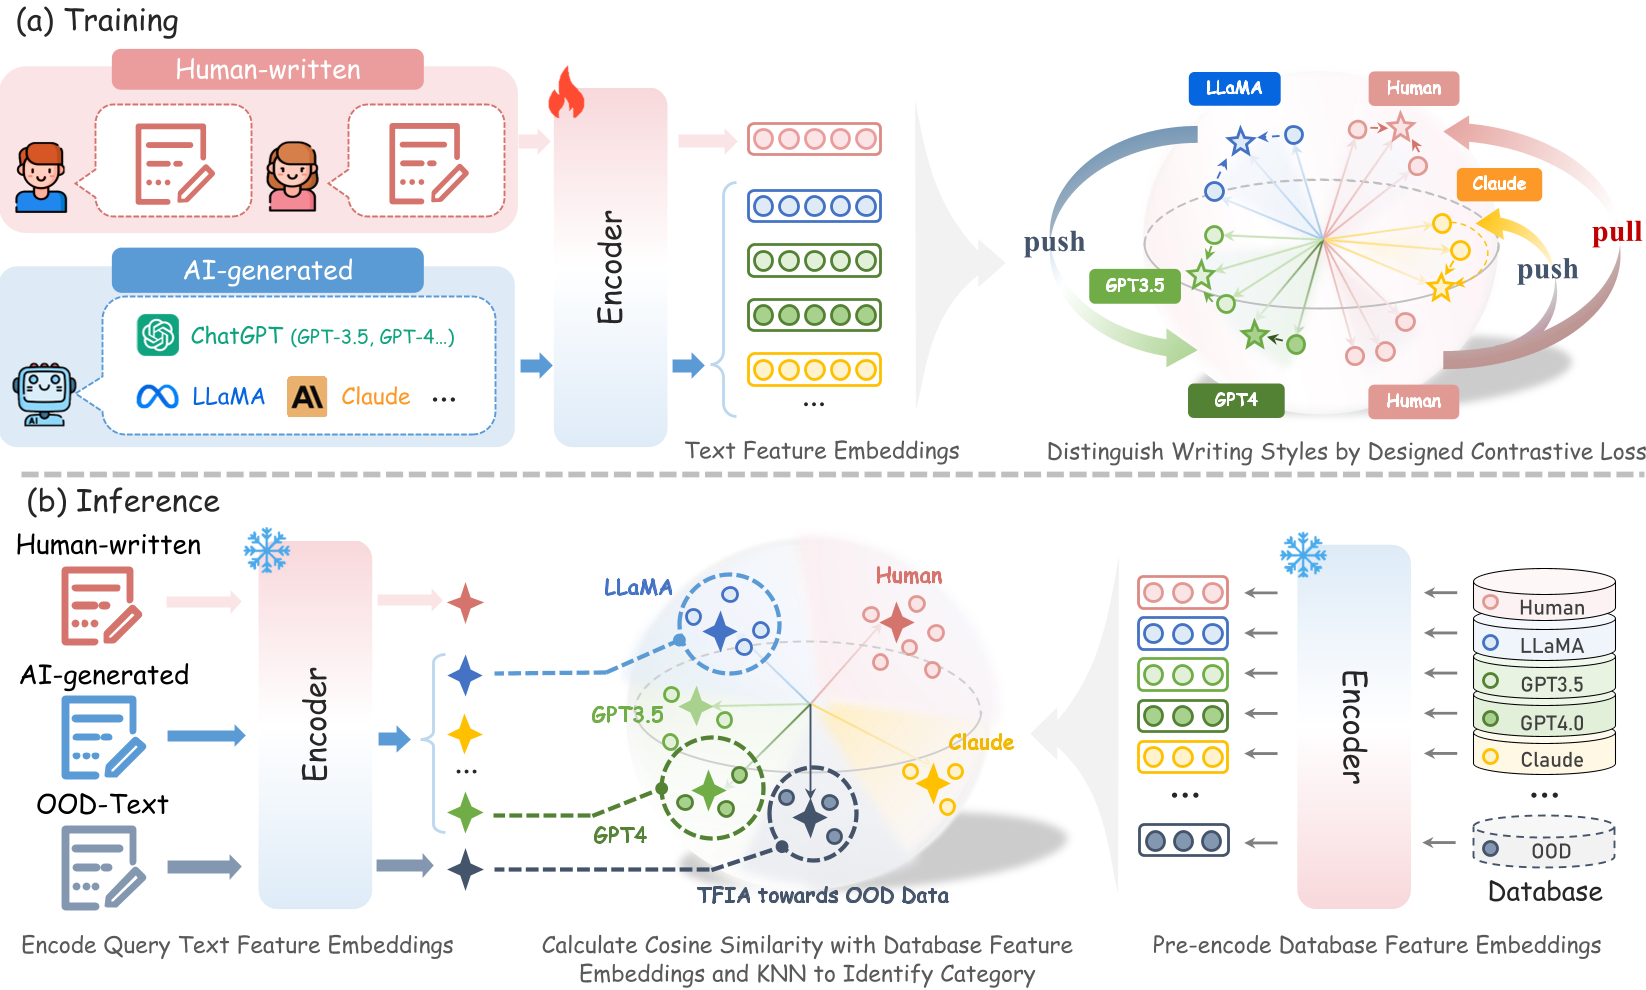 图 1: DeTeCtive 框架概览。左侧为多任务辅助的对比学习训练过程,右侧为基于特征库检索与 KNN 的推理流程。
2. 推理管道:从分类到检索
与传统的 Softmax 分类层不同,DeTeCtive 在推理阶段采用了密集信息检索 (Dense IR) 流程。
- 特征提取:将训练集预先编码并存入向量数据库。
- KNN 判定:对于查询文本,计算其与数据库中已知样本的相似度,通过 K-近邻算法判定来源。 这种设计赋予了模型一个杀手锏:TFIA (Training-Free Incremental Adaptation)。
实验战绩:无惧“域外”挑战
在涵盖 27 个 LLM 和 10 个领域的庞大检测基准 Deepfake 下,DeTeCtive 展现了统治级表现。
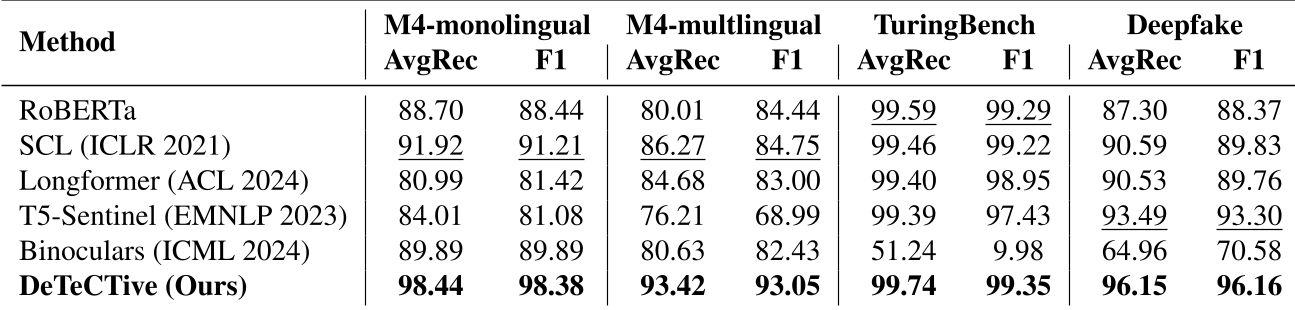 表 1: 在 M4、TuringBench 和 Deepfake 三大主流数据集上的性能对比。DeTeCtive 在各指标上均稳居第一。
TFIA:无需重训练的“增量进化”
最令人惊叹的是其处理未知分布(OOD)的能力。如果遇到一个全新的 LLM 产生的文本,我们不需要重新训练模型,只需要用现有的 Encoder 生成少量该模型的样本特征并存入数据库(即 TFIA 机制),检测器的性能就能瞬间回升。实验显示,这种“免训练适配”在未见域上带来了 7.03% 的额外 AvgRec 提升。
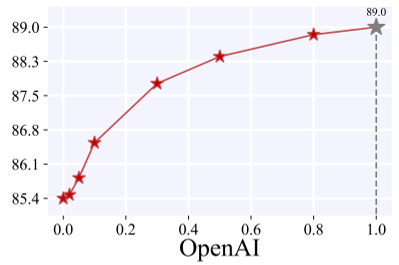 图 2: Embedding 可视化分析。对比 (a) 预训练模型和 (b)-(d) 经过 DeTeCtive 微调后的模型,可以看出后者能清晰地将不同模型家族和作者风格进行聚类。
深度洞察与总结
为什么 DeTeCtive 能赢?
- Inductive Bias 的校准:通过多级对比,强行将 NLP 领域的“作者识别”先验知识注入了检测器。
- 容错性 (Pobustness):基于 KNN 的检索机制比硬分类层具有更好的容错性。实验证明,在面对 DIPPER 或 OUTFOX 等强力混淆攻击时,DeTeCtive 的衰减远小于基线模型。
- 实用性:TFIA 解决了 AI 检测领域“模型更新快于检测更新”的痛点,为工业级部署提供了低成本的路径。
局限性与未来
尽管表现卓越,作者也坦言该工作在可解释性上仍有提升空间——即目前还很难直观解释模型究竟捕捉到了哪些具体的 Token 模式来判定风格。未来的研究可能会聚焦于 Token 级别的解释性分析以及在大规模语料库上的进一步预训练。
结语:DeTeCtive 证明了在生成式 AI 时代,检测器的核心竞争力不再是“记住错误”,而是“理解风格”。