
DeTeCtive:重塑 AI 文本检测,从二分类走向风格识别的深度表征
DeTeCtive: Detecting AI-generated Text via Multi-Level Contrastive Learning
本文提出了 DeTeCtive,一个基于多任务辅助和多级对比学习(Multi-Level Contrastive Learning)的 AI 生成文本检测框架。该方法通过将检测任务从传统的二分类转变为对不同作者写作风格的分辨,在 Deepfake、M4 等多个基准测试中达到了 SOTA 水平,并展现出卓越的泛化能力。
TL;DR
字节跳动与中国科学院大学的研究团队提出了 DeTeCtive 框架,将 AI 文本检测从“人类 vs AI”的刻板二分类任务,升级为对多样化写作风格的精细辨析。通过多级对比学习,DeTeCtive 在多个基准测试中刷新了 SOTA 记录,尤其在应对从未见过的模型和领域(OOD)时展现了惊人的泛化力。
1. 痛点:为什么传统的检测器总是在“开天窗”?
当前的 AI 检测器(如基于 RoBERTa 的分类器)面临一个核心尴尬:在训练集内表现极佳,一旦遇到新模型(如 Llama 3 刚发布)或新领域(如从新闻转到代码注释),准确率就会断崖式下跌。
研究者指出,问题的根源在于我们过去把 AI 生成的文本看作是一个单一的整体(Distribution P3),而忽略了不同 LLM 其实就像不同的“作家”,拥有独特的 写作风格(Writing Style)。与其教模型去认什么是“假”的,不如教模型去认什么是“字节跳动的风格”、“OpenAI 的风格”或“人类的风格”。
2. 核心机制:多级对比学习 (Multi-Level Contrastive Learning)
DeTeCtive 的核心是一个精妙设计的损失函数。它不只是让 AI 和人类的特征拉远,而是建立了一套亲疏有别的“族谱”关系:
- 第一级:区分人类(Human)与所有 AI。
- 第二级:区分不同的 AI 模型家族(如 GPT 系列 vs Llama 系列)。
- 第三级:区分同一家族内的具体版本(如 GPT-3.5 vs GPT-4)。
这种多级约束迫使模型在特征空间中构建出极其细致、具有判别性的向量表征。
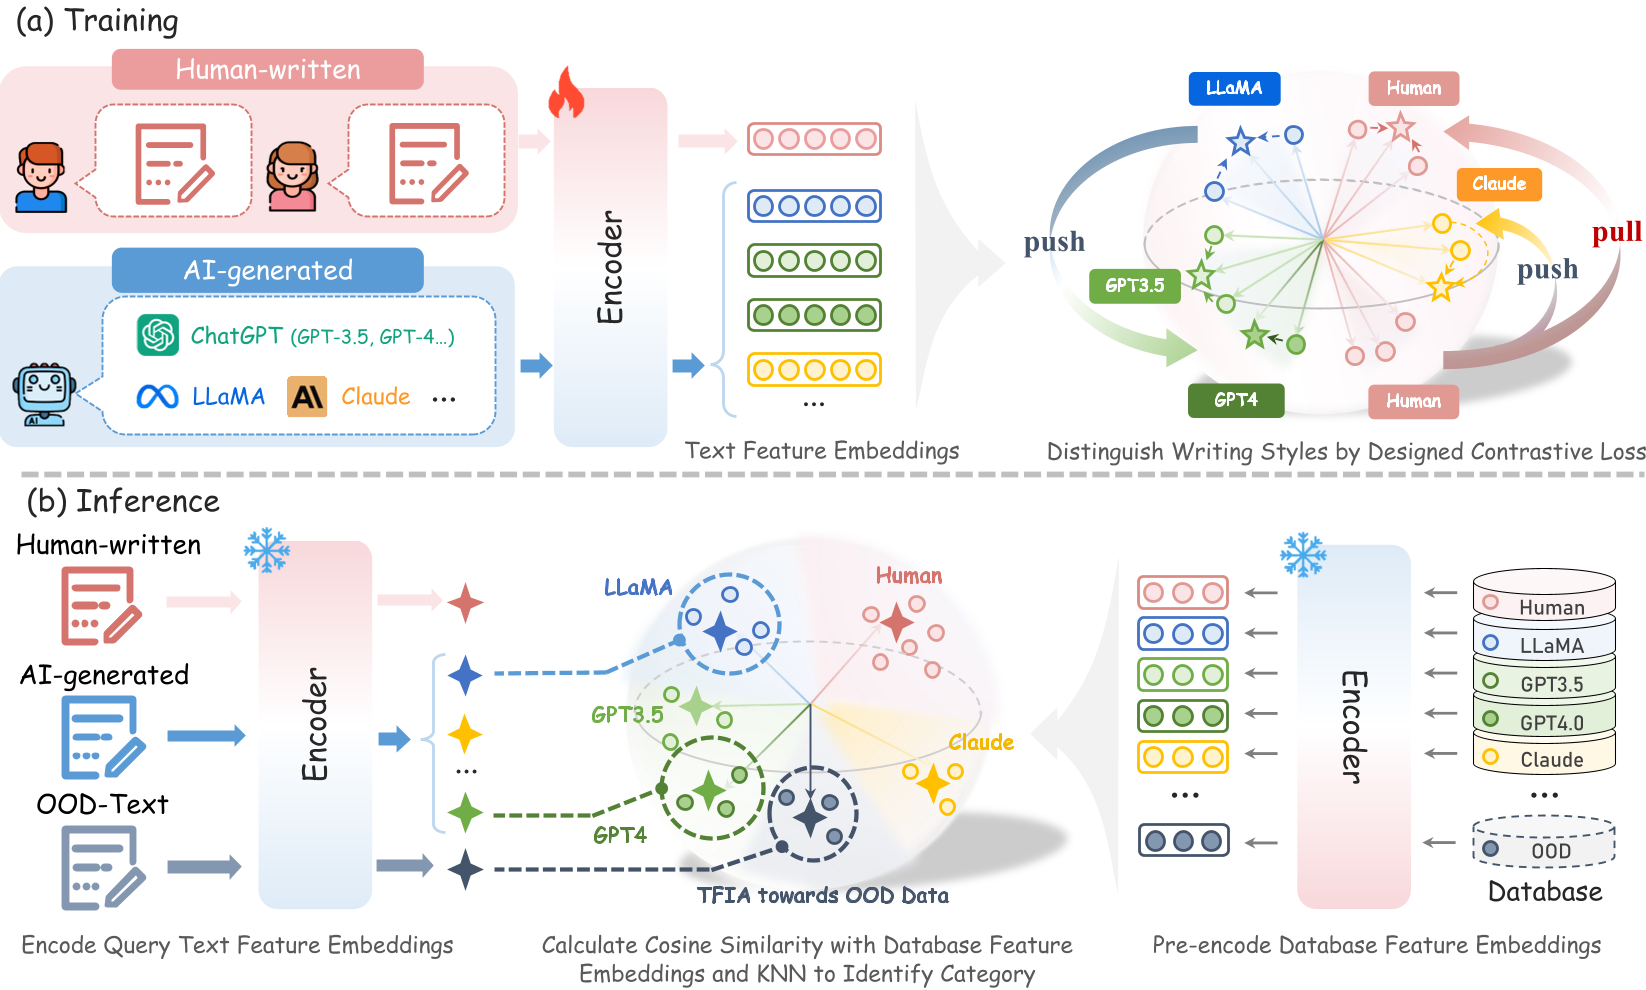 图 1:DeTeCtive 框架概览。左侧展示了多级对比损失的结构,右侧展示了基于 KNN 的推理流。
3. 推理端的革新:从分类头到检索管线
与普通模型使用一个固定的线性层(Classification Head)不同,DeTeCtive 采用了 密集检索(Dense Retrieval) 逻辑:
- 预存:将训练集的特征向量存入 Faiss 数据库。
- 检索:测试新文本时,计算其特征并查询数据库中最近的“邻居”。
- 判定:通过 KNN 算法得出最终类别。
这种设计引出了本文最令人关注的特性:免训练增量适配 (TFIA)。当出现新模型(如 GPT-5)时,你不需要重新训练模型,只需把少量新样本的特征向量丢进数据库,检测器就能立刻具备识别该新模型的能力。
4. 实验战绩:全场景霸榜
DeTeCtive 在 Deepfake、M4 和 TuringBench 三大权威数据集上进行了全方位测试,结果令人印象深刻:
- 泛化性溢出:在从未见过的模型(Unseen Models)上,AvgRec 达到 92.19%;在从未见过的领域(Unseen Domains)上,性能提升比前人高出 14% 以上。
- 抗攻击性:面对 DIPPER 等复杂的改写(Paraphrasing)攻击,其 F1 值依然保持在 96.9% 以上,远超同类检测器。
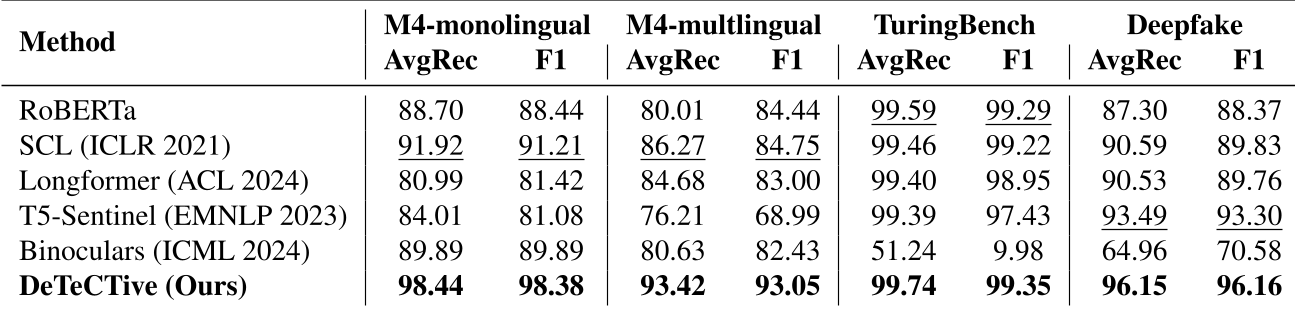 表 1:在多个基准测试中的 SOTA 表现对标。
此外,通过 UMAP 可视化可以清晰看到,DeTeCtive 学习到的特征空间极具层次感,不同模型的聚类界限分明。
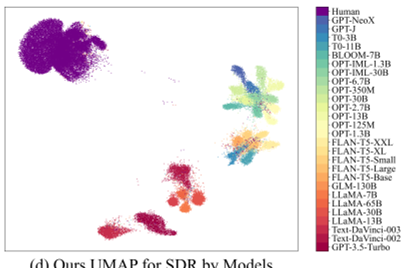 图 2:特征空间的 UMAP 可视化。可以看到 fine-tuned 后的模型(b, c, d)能有效分离复杂的写作风格。
5. 总结与洞察
DeTeCtive 的成功证明了:AI 检测不应是简单的真假判别,而应是高维风格空间中的指纹比对。
局限性: 尽管检测能力极强,但该文尚未深入探讨其在 Token 级别的可解释性(即到底哪个词出卖了 AI),且检索式方法在超大规模数据库下的内存开销仍是工业界落地需要权衡的因素。
对于开发者而言,DeTeCtive 提供的 TFIA 思路非常具有落地价值:在面对 LLM 的爆发式迭代时,动态维护特征库可能是比频繁微调模型更低碳、更高效的防御手段。