
ActNet:超越 KAN,基于叠加定理重塑物理感知神经网络
Deep Learning Alternatives of the Kolmogorov Superposition Theorem
本文提出了 ActNet,一种基于 Laczkovich 版本柯尔莫哥洛夫叠加定理 (KST) 的新型深度学习架构,专门用于替代 Kolmogorov-Arnold Networks (KANs)。该方法通过引入可训练的激活函数层 (ActLayer),在 Physics-Informed Neural Networks (PINNs) 任务中实现了超越 MLP 和 KAN 的 SOTA 性能。
TL;DR
最近,Kolmogorov-Arnold Networks (KANs) 在学术界掀起了“替代 MLP”的热潮,但其复杂的参数化和扩展性问题也引来不少质疑。宾夕法尼亚大学的研究团队提出的 ActNet 给出了一份标准答案:通过采用更现代的 Laczkovich 版本柯尔莫哥洛夫叠加定理 (KST),ActNet 不仅解决了 KAN 的参数和速度痛点,更在物理informed (PINNs) 任务中全面碾压了 KAN 与主流的 MLP 基线。
痛点深挖:KAN 的“数学优雅”与“工程尴尬”
柯尔莫哥洛夫叠加定理 (KST) 证明了任何多变量函数都能拆解为单变量函数的叠加。KAN 虽然以此为基础,但它使用的是 1957 年的最原始公式:
- 扩展性瓶颈:需要 个未知函数,维度越高,参数暴增。
- 数值不稳定:在 PINNs 这种极度依赖导数信息的任务中,KAN 常用的 B-splines 容易出现“导数消失”或震荡。
- 效率低下:在现代 GPU 架构上,KAN 的计算效率远低于矩阵运算优化的 MLP。
核心直觉:从 Laczkovich 定理到 ActLayer
ActNet 的核心在于它没有死守 1957 年的旧公式,而是借鉴了 Laczkovich (2021) 的新证明。这个版本的 KST 具有三大优势:
- 线性扩展:未知函数仅需 个,极大降低了复杂度。
- 全空间适用:不限于单位立方体 ,而是适用于全实数空间 。
- 多头注意力视角:每个 ActLayer 都可以看作是一个“多头 MLP”,每个头拥有独立且可训练的激活函数 。
模型架构解析
ActLayer 的前向传播可以精简为一行代码实现:out = einsum('ij,jk,ik->k', B(x), β, λ)。它通过一组正弦基函数的线性组合来动态学习最优激活函数。
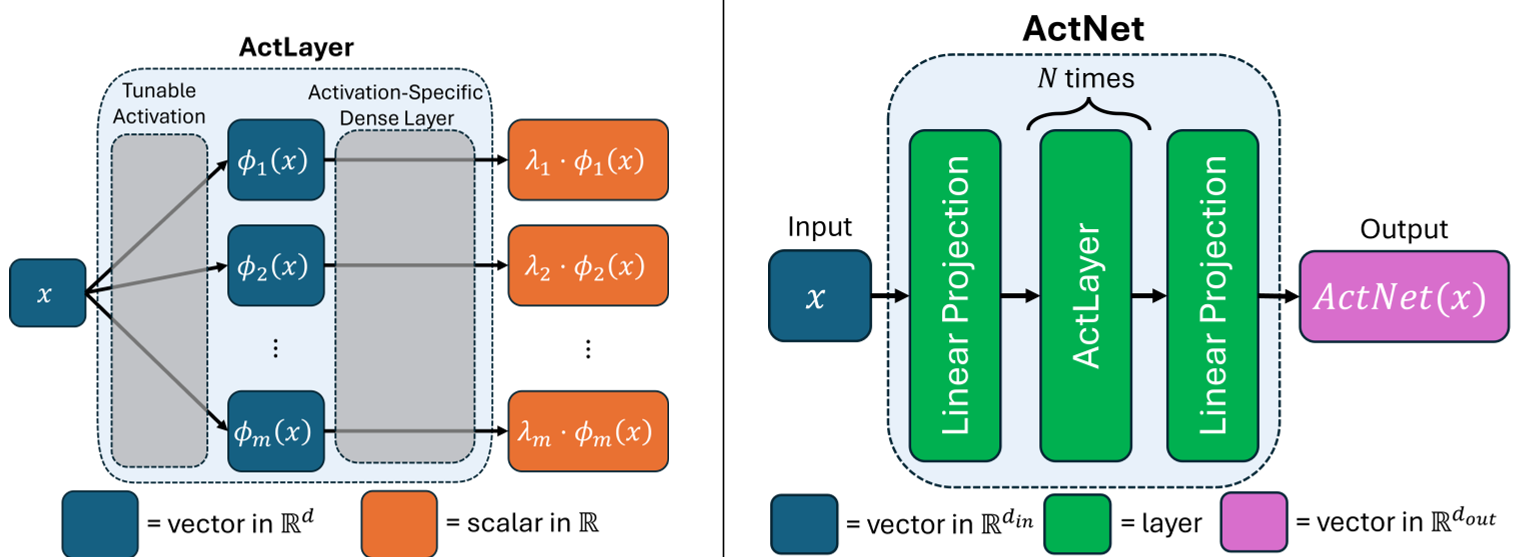 左图:ActLayer 内部结构;右图:ActNet 整体架构,包括嵌入层、L层 ActBlock 和线性输出层。
稳定性的魔法:统计初始化
传统的深度网络经常受到梯度消失或爆炸的困扰。作者提出了一个精妙的初始化方案(Theorem 3.4),证明了在输入符合 时,通过特定的 和 缩放,ActLayer 的输出依然能严格保持均值 0 和方差 1。这使得 ActNet 能够轻松堆叠到更深的层数而无需担心训练崩溃。
实验战绩:PINNs 环境下的全面统治
在科学计算中,模型需要通过最小化 PDE 残差(物理规律)来学习隐含函数。实验选取了 Poisson、Helmholtz、Allen-Cahn 等经典方程。
- 性能碾压:在处理高度震荡的 Helmholtz 方程时(),ActNet 的误差比 KAN 降低了两个数量级以上。
- SOTA 挑战:在混沌的 Kuramoto–Sivashinsky 方程任务中,ActNet 击败了目前最强的 PINNs 模型 PirateNet。
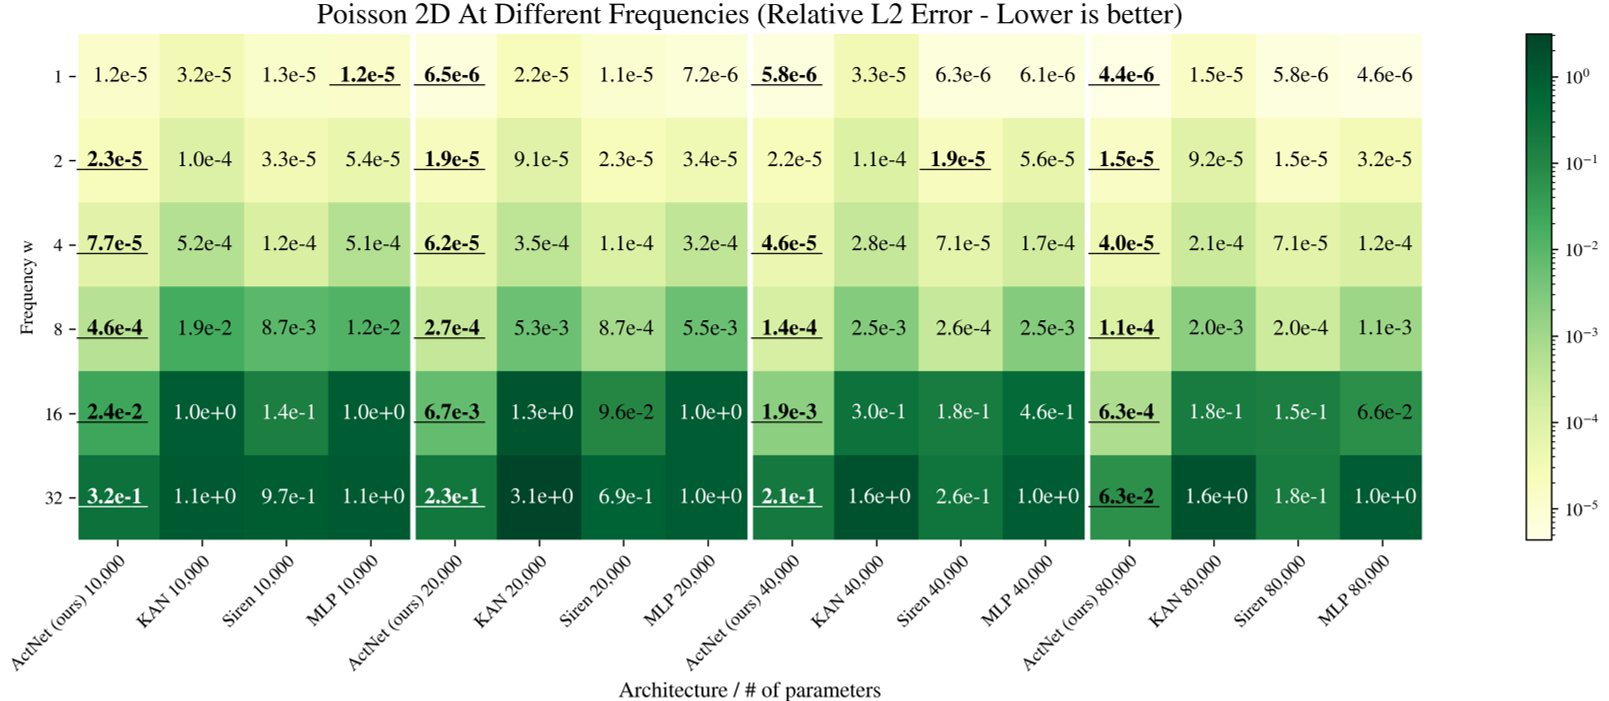 在 Poisson 问题中,ActNet 在不同参数规模下均表现出最低的 Relative L2 Error(划线部分)。
深度洞察与总结
ActNet 的出现标志着 KST 架构从“数学原型”走向“工业实用”。它保留了 KAN 动态学习激活函数的灵活性,又通过多头结构和线性扩展解决了计算效率问题。尤其是其导数不会退化的特性,使其成为未来科学人工智能 (AI for Science) 的强力候选项。
局限性:尽管比 KAN 快,但 ActNet 相比最纯粹的 MLP 仍有 2-3 倍的计算延迟。未来的优化方向可能在于像 FlashAttention 一样,在算子层面针对 ActLayer 进行定制化优化。
启示:回归数学经典理论并结合现代深度学习的初始化技巧,往往能碰撞出比单纯堆肉(增加参数)更高效的架构设计。