
SCRN:通过重构与校准,构筑AI生成文本检测的坚固护城河
Are AI-Generated Text Detectors Robust to Adversarial Perturbations?
本文针对AI生成文本(AIGT)检测器在面对对抗性扰动时鲁棒性不足的问题,提出了Siamese Calibrated Reconstruction Network (SCRN)。该方法通过重构网络模拟文本噪声并结合孪生校准技术,在包含GPT-4等多种模型的跨领域、跨语料场景下,比现有SOTA方法提升了6.5%至18.25%的攻击下准确率。
TL;DR
随着大语言模型(LLM)的普及,识别AI伪造文本变得至关重要。然而,目前的检测器非常脆弱——一个小小的单词拼写改动就能骗过它们。本文介绍的 SCRN (Siamese Calibrated Reconstruction Network) 通过让模型在“噪声中识真本”和“保持预测定力”两大策略,显著提升了检测器在遭遇对抗攻击时的鲁棒性,在跨领域测试中将准确率提升了惊人的18.25%。
背景定位:脆弱的“金标准”
在学术界,我们通常使用探测器来防止AI代写论文或散布虚假信息。目前的方案无论是基于数学指标(如Log-Rank)还是深度学习(如RoBERTa),都存在严重的诱导偏向。它们太“细心”了,以至于文本中极微小的扰动(如插入空格、同义词替换)就会导致判断结果的彻底反转。这不仅是鲁棒性问题,更是模型缺乏对文本高层语义理解的表现。
痛点深挖:Token级特征的陷阱
作者指出,现有的RoBERTa基线模型在面对“避税式”修改(Evasion Attack)时几乎毫无还手之力。这背后的直觉是:模型在训练时学到的是特定Token的分布规律,而非深层逻辑。如果AI生成的文本经过微调,其统计特征就会向人类分布偏移,从而导致检测器失效。
方法论详解:SCRN 核心架构
SCRN 的核心贡献可以拆解为两个部分:提取抗扰特征与强化预测一致性。
1. 抗扰重构网络 (Reconstruction Network)
SCRN 在 Encoder (RoBERTa) 之后接了一个重构模块。它模仿了去噪自编码器的逻辑:
- 显式分解:将隐空间向量 分解为语义项 (Semantic) 和扰动项 (Perturbation)。
- 主动加噪:向扰动项注入随机高斯噪声 。
- 去噪还原:让 Decoder 尝试恢复原始 token 表示,迫使模型学会忽略这些干扰。
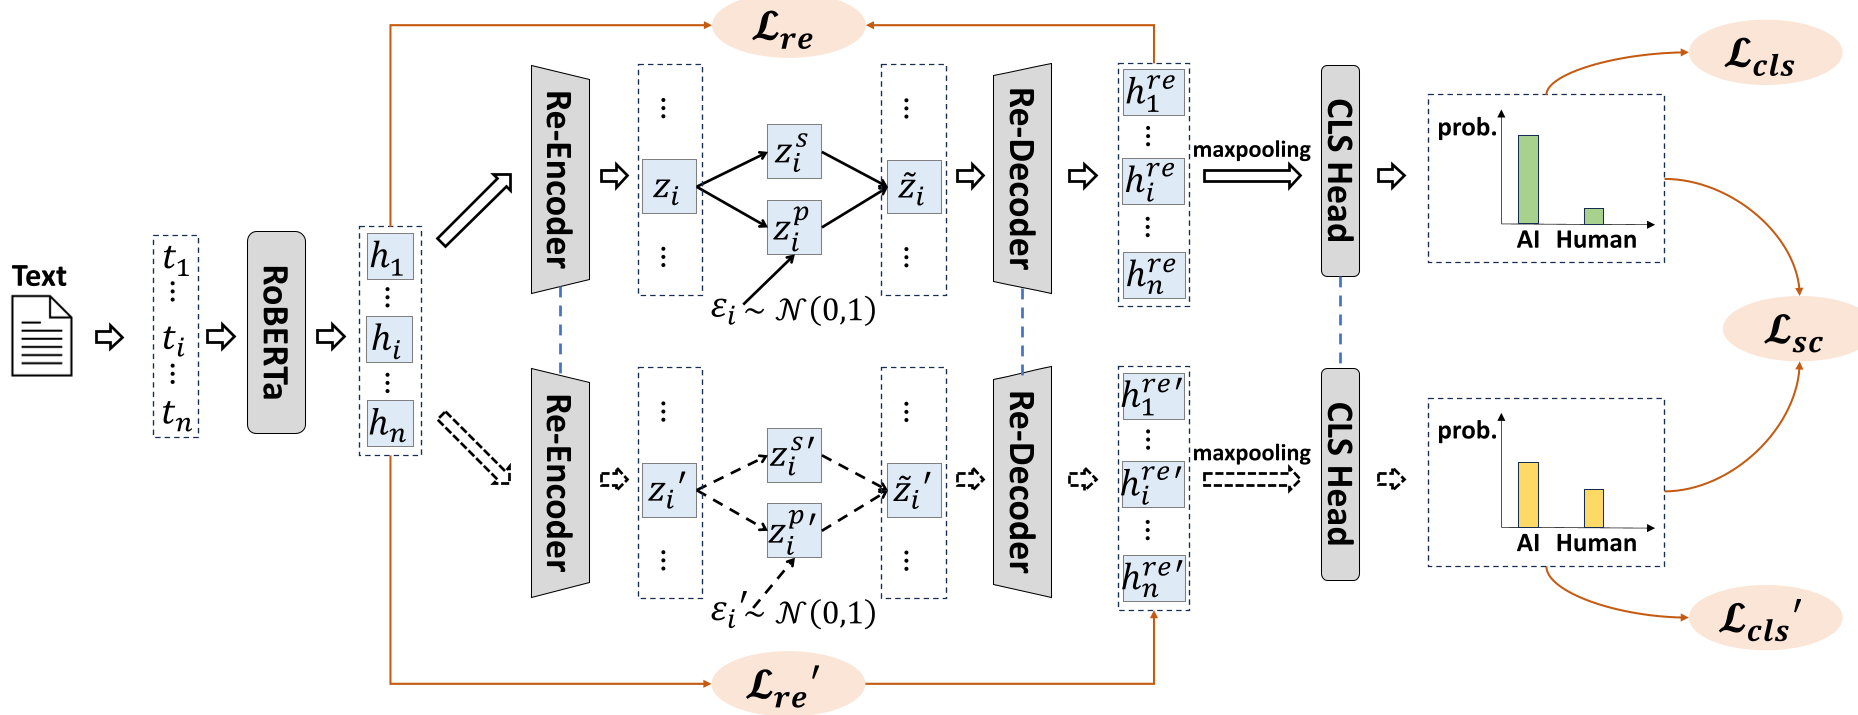 Figure 2: SCRN 架构图,展示了双分支结构与重构流
2. 孪生校准 (Siamese Calibration)
这是本文的“点睛之笔”。作者发现,仅仅能抗干扰还不够,模型在不同噪声下的判断必须“稳如泰山”。
- 对称 KL 散度:在训练阶段,同一段文字会带上两份不同的独立噪声,分别通过模型。
- 惩罚波动:即便两分支预测结果都是正确的(比如都是 0.999 和 0.95 判定为 AI),由于 KL 散度对置信度的微小差异非常敏感,模型仍会受到惩罚。这迫使模型放弃边缘特征,转而寻找最本质的语义证据。
实验与结果:全场景领跑
作者在 HC3、TruthfulQA 等四个数据集上进行了大考,覆盖了“同域”、“跨域”、“跨文体”以及“混合AI来源”等复杂场景。
核心战绩
在最严苛的对抗攻击(如 PWWS)下:
- 跨领域能力:在 TruthfulQA 数据集上,AUA(攻击下准确率)比 SOTA 提升了 18.25%。
- 跨文体能力:在识别新闻与创意写作时,AUA 提升了 14.5%。
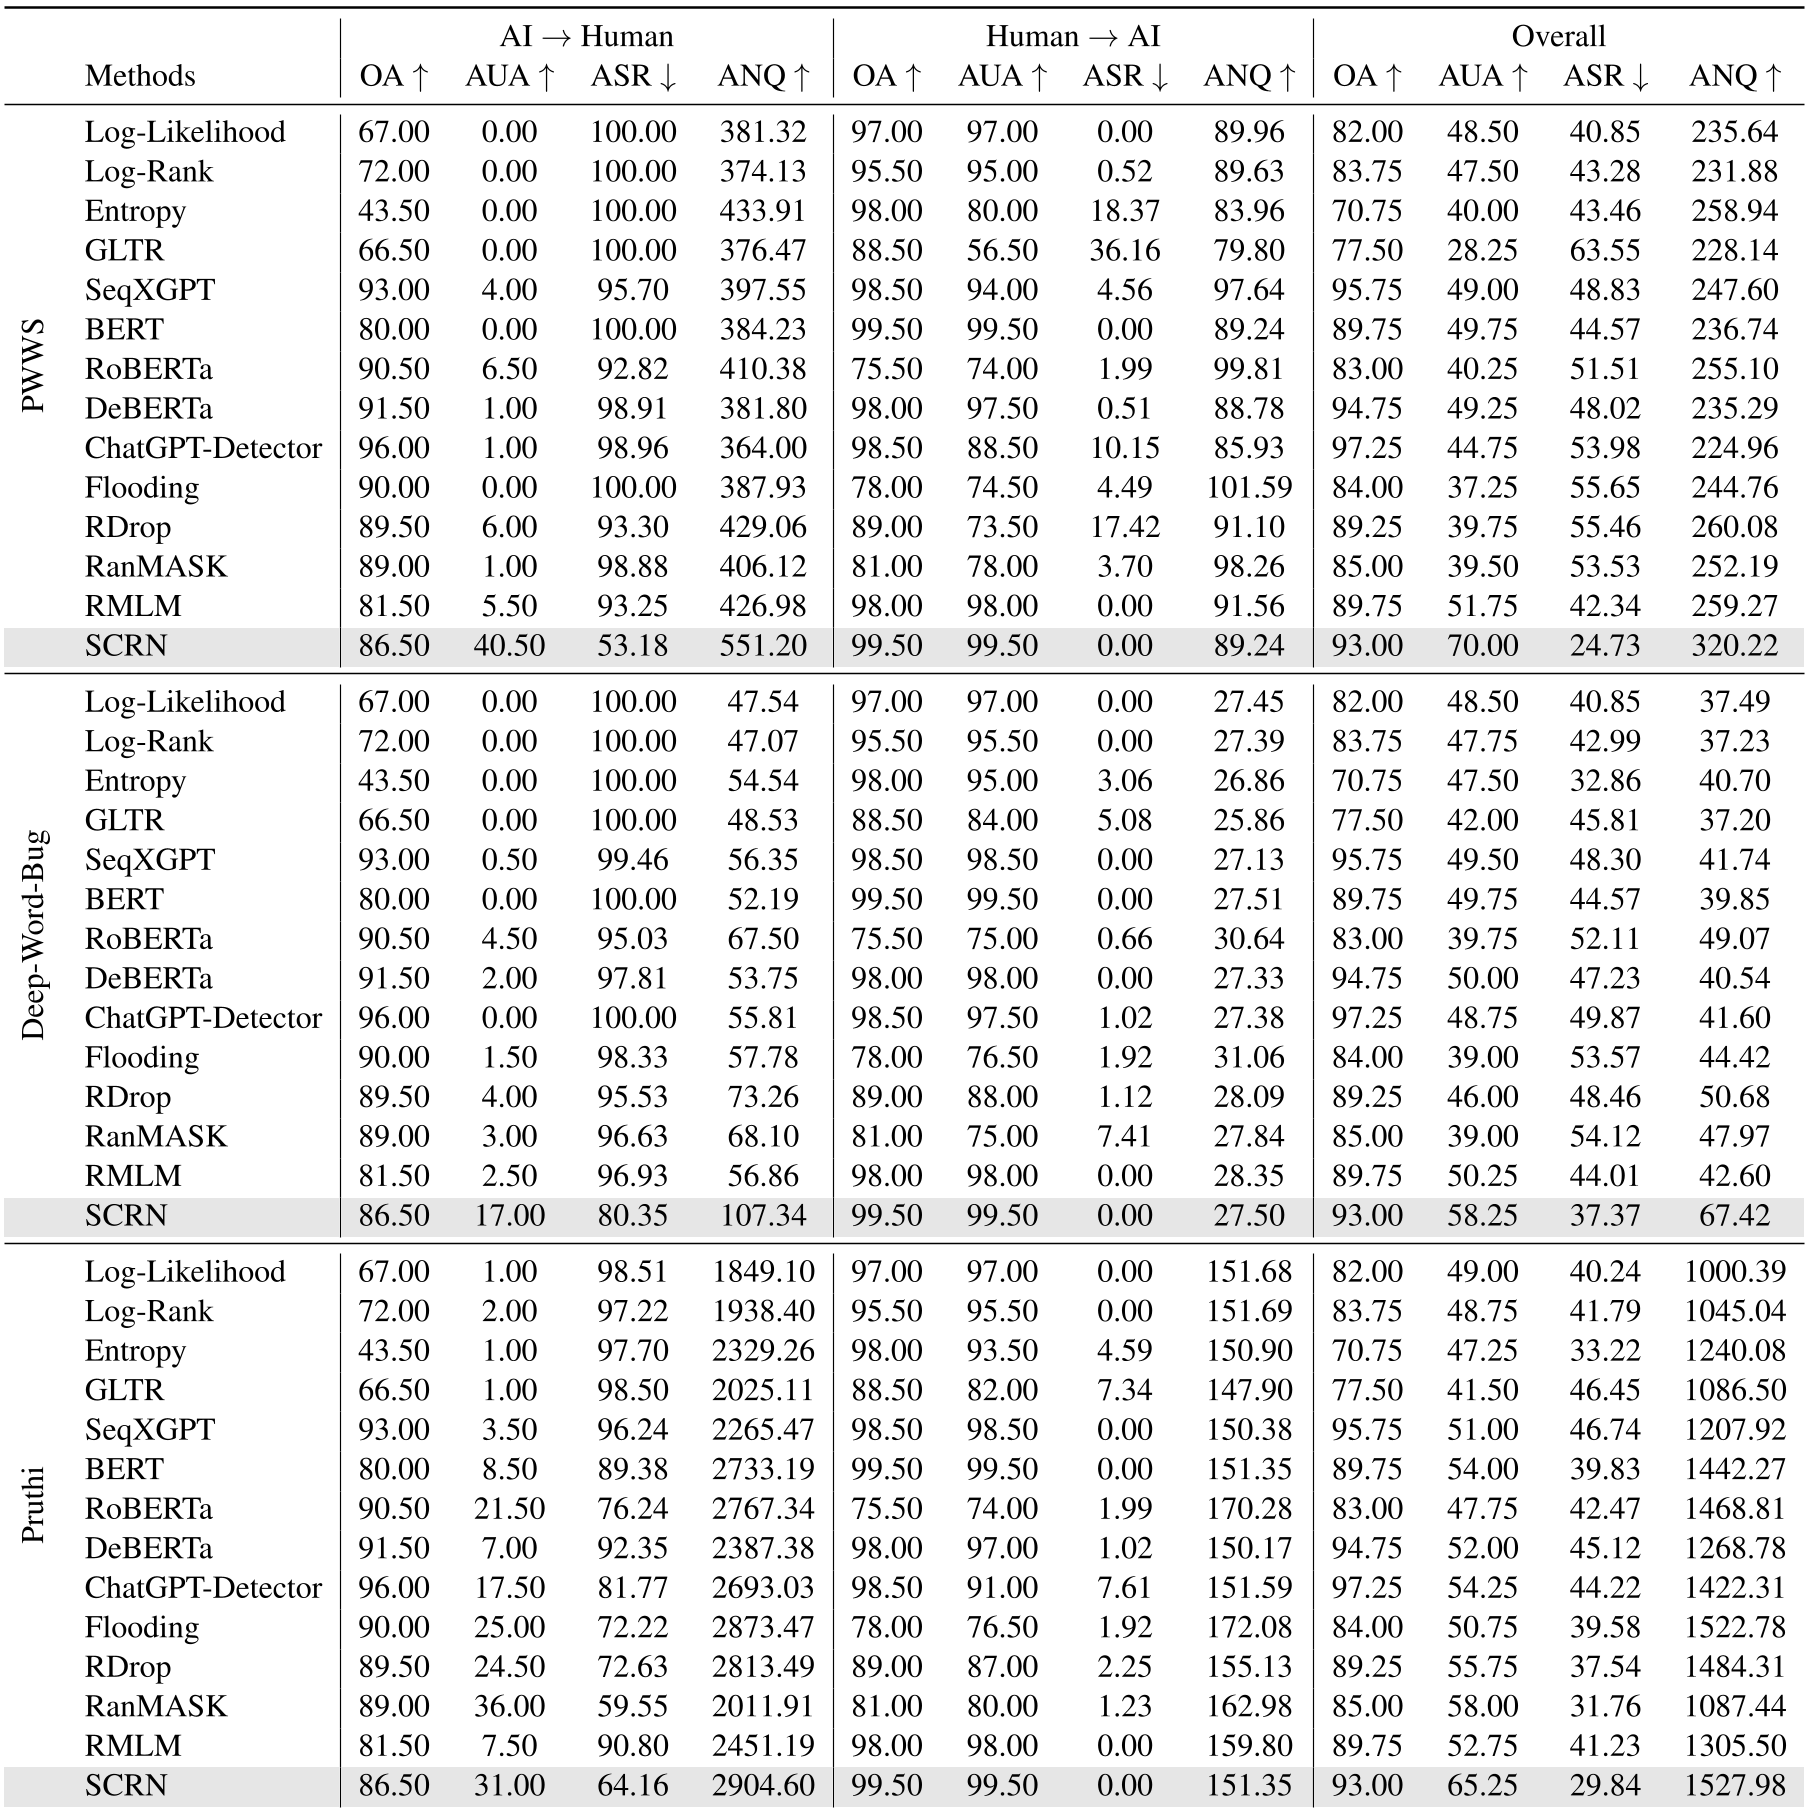 Table 16: Ghostbuster 数据集(跨文体场景)下的鲁棒性对比,SCRN 展示了极强的防御韧性
消融实验:缺一不可
如 Table 10 所示,如果去掉孪生校准(-SC),模型在跨领域任务中的 AUA 会从 70.0% 直降到 42.5%。这证明了预测一致性训练是模型从“死记硬背特征”转向“理解深层语义”的关键催化剂。
深度洞察与总结
总结 (Takeaway)
SCRN 的成功证明了,在 AIGC 检测这个领域,“稳定的置信度”比“瞬时的准确度”更具防御价值。通过重构网络的去噪过程和孪生校准的一致性约束,我们能够构建出真正具备商用价值、能抵御恶意攻击的检测工具。
局限性 (Limitations)
- 重改写攻击:虽然能抵御字符和词级的扰动,但如果攻击者进行语义级重写(Paraphrasing),SCRN 依然面临挑战。
- 语言局限:目前实验主要集中在英语语料,多语言环境下的泛化性尚待验证。
未来展望
SCRN 的思路不仅能用于文本检测,这种“重构+校准”的范式完全可以迁移到图像伪造检测或音频伪造检测中,成为提升多模态鲁棒性的通用策略。